


数据库入门到初级 · 第 11/22 篇。实验口径:MySQL 8.4、InnoDB、utf8mb4。案例:小型商城。
用户名字在 users,订单金额在 orders。如果想展示“小林的订单 1001,金额 288 元”,就需要把两张表按用户编号组合起来。JOIN 的关键不是背图形,而是明确“每一行该与谁匹配”。
1. 内连接:只保留双方匹配的组合
SELECT o.id AS order_id, u.name, o.total_amount
FROM orders AS o
INNER JOIN users AS u ON u.id = o.user_id
ORDER BY o.id;
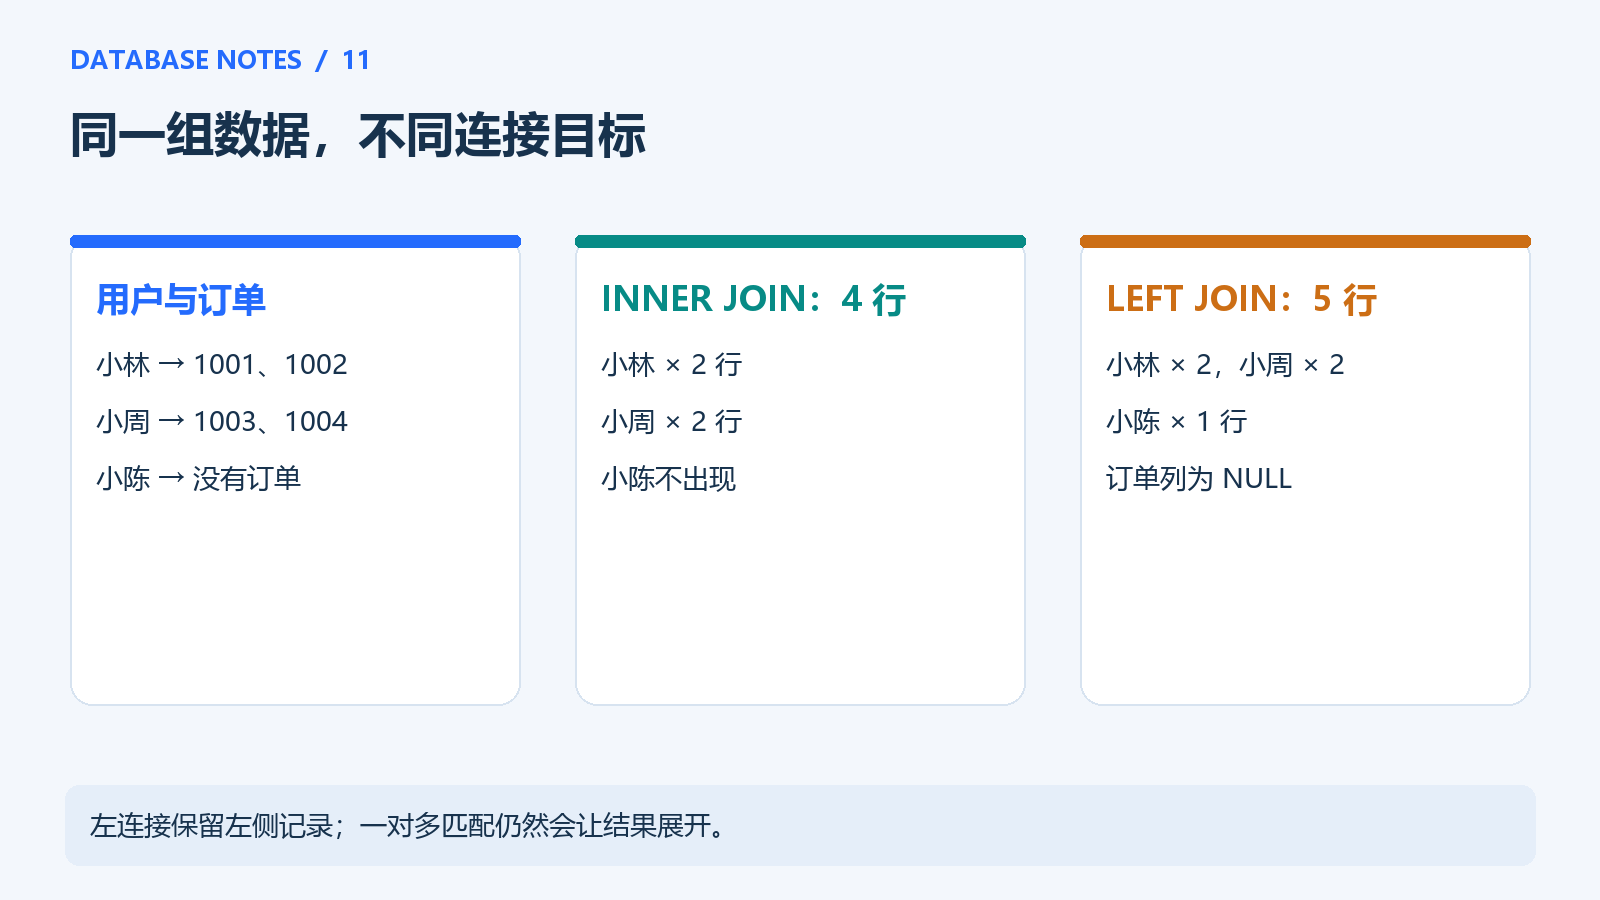
样例输出 4 行:小林对应 1001、1002,小周对应 1003、1004。小陈没有订单,所以不会出现。
ON u.id = o.user_id 是匹配规则;它不是“字段名字相似就自动关联”。u、o 是表别名,给字段加上来源前缀,也能避免两张表都有 id 时产生歧义。
2. 左连接:没有订单的用户也要展示
SELECT u.id AS user_id, u.name, o.id AS order_id
FROM users AS u
LEFT JOIN orders AS o ON o.user_id = u.id
ORDER BY u.id, o.id;
结果有 5 行:小林两行、小周两行,小陈一行。小陈那行的 order_id 是 NULL,表示没有匹配的订单,不是数据库里真的多了一张空订单。
所以,左连接不保证输出行数等于左表行数。它保证保留左侧记录;一条左侧记录匹配多条右侧记录时,仍然会展开成多行。
3. ON 与 WHERE 的位置会改变含义
需求:“展示所有用户,以及他们的已支付订单。”
SELECT u.id, u.name, o.id AS order_id
FROM users AS u
LEFT JOIN orders AS o
  ON o.user_id = u.id AND o.status = 'paid'
ORDER BY u.id, o.id;
结果保留三名用户,小周和小陈的订单列为空。如果把状态条件改放到 WHERE o.status = 'paid',没有匹配记录的行也会被过滤,只剩小林。两种写法都能运行,但回答的是不同问题。
4. 统计全部用户的已支付消费
SELECT u.id, u.name,
       COUNT(o.id) AS paid_order_count,
       COALESCE(SUM(o.total_amount), 0) AS paid_amount
FROM users AS u
LEFT JOIN orders AS o
  ON o.user_id = u.id AND o.status = 'paid'
GROUP BY u.id, u.name
ORDER BY u.id;
小林是 2 单、417 元,小周和小陈均为 0。这里不能使用 COUNT(*) 表示订单数量,因为无订单用户也有一行左连接占位结果;应统计非空的订单主键。
5. 为什么连接明细后金额翻倍了
订单 1001 有两条明细。把订单与明细连接后,该订单的 total_amount=288 会在两行里重复出现。如果这时直接 SUM(o.total_amount),就会把 288 算两次。
正确做法取决于目标:统计订单总额时直接从订单表聚合;统计商品成交金额时,用 unit_price * quantity;确实需要多表统计时,先把明细汇总到一张订单一行,再连接。
不要用 SUM(DISTINCT total_amount) 修复重复,因为两张不同订单可能恰好金额相同,会被错误合并。去重必须围绕记录身份和业务粒度,而不是只看金额值。
6. 漏掉连接条件会怎样
3 名用户与 4 张订单如果不加匹配条件全部组合,会得到 12 行。数据量增大后,组合会迅速膨胀。写连接时先检查 ON,再检查每一层是一对一还是一对多。
练习与答案
练习:找出从未下单的用户。
SELECT u.id, u.name
FROM users AS u
LEFT JOIN orders AS o ON o.user_id = u.id
WHERE o.id IS NULL;
结果是小陈。判断右表非空主键是否为空,比判断可能本来就可空的备注字段更可靠。
延伸阅读
上一篇:第 10 篇 · 系列目录 · 下一篇:第 12 篇