


适用:使用 systemd 的 Linux 服务器、常规 rootful Docker Engine;Compose 示例使用
docker composeV2。本文为教学故障场景,错误文本和结果为示意,具体输出以现场为准。
一、遭遇情况:服务突然退出,重启后又正常一会儿
API 容器运行一段时间后消失,docker ps -a 显示 Exited (137)。日志最后几行没有异常堆栈。有人认定“必然 OOM”,直接把内存限制翻倍。
137 在常见退出状态表示中对应进程被 SIGKILL 终止,是重要线索,但不是独占的 OOM 标签。人为 docker kill、停止超时后的强杀,也可能留下同类退出码。
本篇案例设定为容器设置 128 MiB 内存限制,而应用持续分配内存,最终触发容器内存限制相关的 OOM。必须通过更多证据确认,不能只靠数字猜。
二、原因分析:主机有空闲内存,容器也可能 OOM
容器设置了内存上限时,达到自身 cgroup 限制就可能触发 OOM,即使宿主机整体仍有空闲。反过来,未设置限制也不代表安全,多个容器可能共同耗尽宿主机资源。
应用可用内存也不只包括业务堆。例如 Java 还有线程栈、直接内存、元空间等;把 -Xmx 设成与容器限制完全相同,容易没有余量。
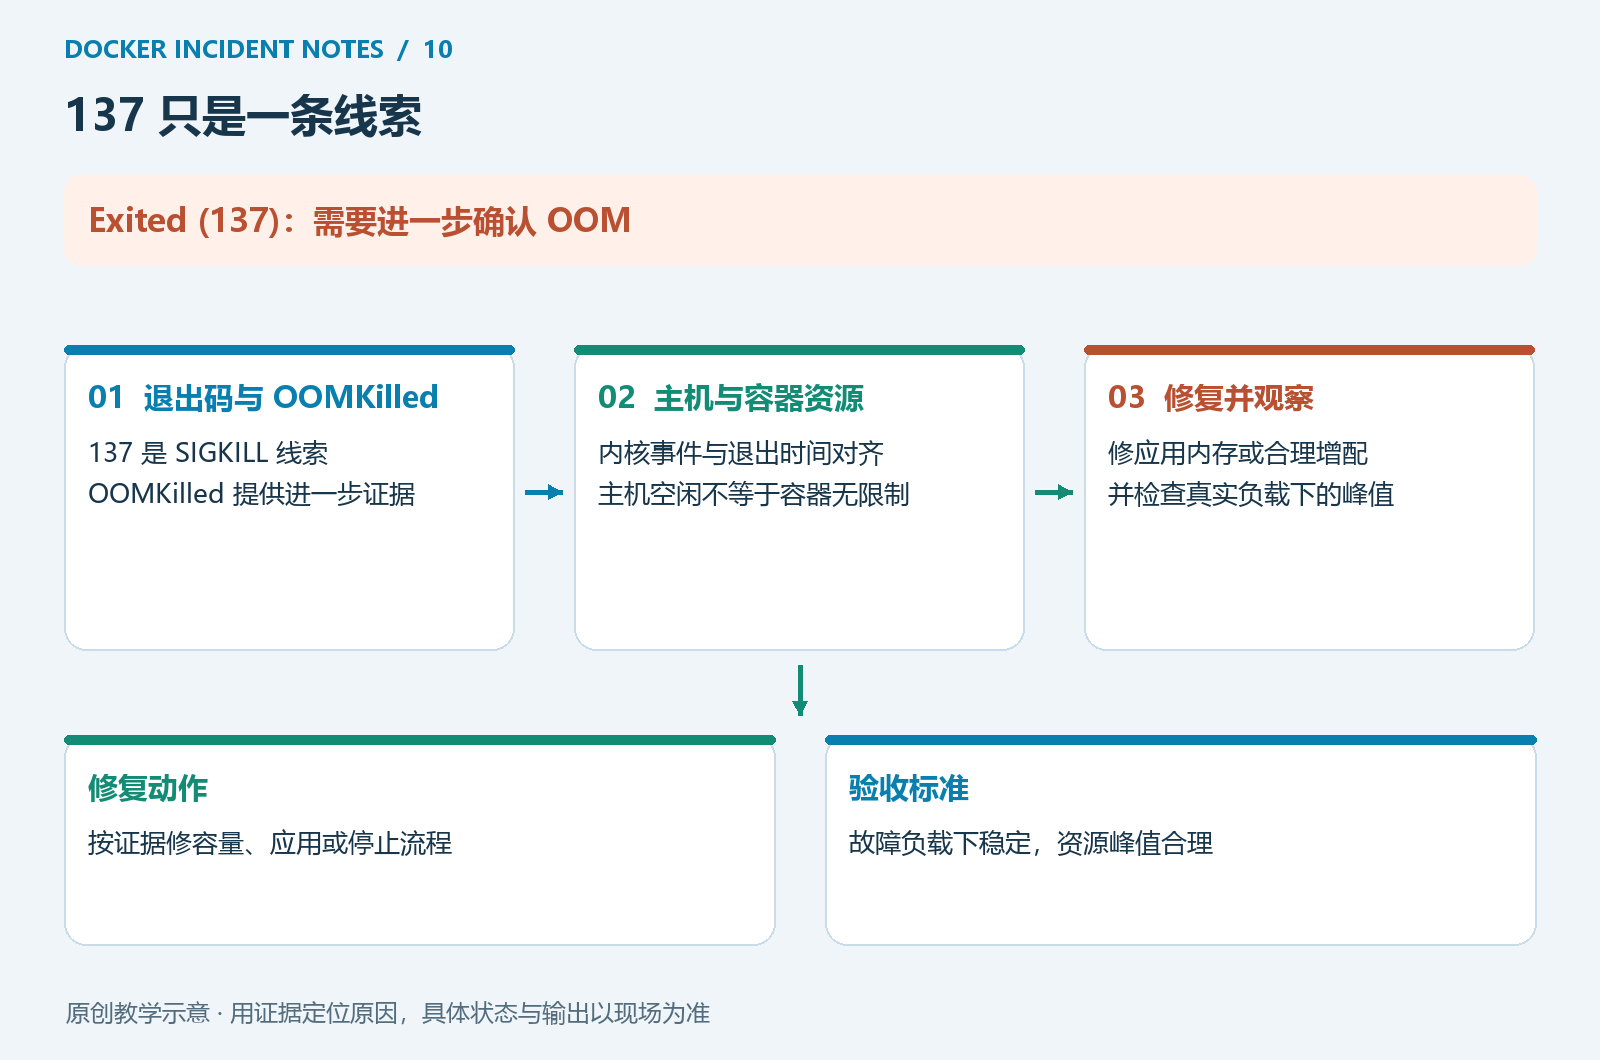
三、排查思路:把四类证据对齐
1. 读取退出状态和内存限制
docker inspect api --format 'Exit={{.State.ExitCode}} OOMKilled={{.State.OOMKilled}} Finished={{.State.FinishedAt}}'
docker inspect api --format 'Memory={{.HostConfig.Memory}} MemorySwap={{.HostConfig.MemorySwap}}'
docker stats --no-stream api
Memory 的原始数值单位是字节,0 通常表示未设置容器级硬限制,不表示容器能无限使用物理内存。已经退出的容器无法依靠当前 stats 还原过去峰值,所以要结合监控记录。
自动重启后的状态可能反映最近一次运行,尽量及时采集。OOMKilled=true 是强线索,但缺少标记时也应根据内核事件和时间线继续判断。
2. 检查主机与内核事件
free -h
sudo journalctl -k --since '30 minutes ago' --no-pager | grep -Ei 'out of memory|oom|killed process'
docker logs --tail 100 --timestamps api
将内核 OOM 时间、进程名和容器退出时间对齐。若没有 OOM 证据,查看同一时间是否有发布、人工停止或平台操作。内核日志保留和访问权限不同,“没查到”不等于“绝不可能发生”。
四、实践:仅在资源充足的测试机复现
不要对承载业务的容器注入内存压力。下面创建独立实验容器,设置 128 MiB 上限,并把 memory-swap 设成相同值以不提供额外 swap 配额;要求系统实际支持相关限制。
docker run -d --name dt10-oom --memory=128m --memory-swap=128m python:3.12-alpine python -u -c 'import time; blocks=[]; print("allocating", flush=True)
while True:
    blocks.append(bytearray(8*1024*1024))
    time.sleep(0.2)'
在另一终端观察:
docker stats dt10-oom
用 Ctrl+C 退出 stats 只结束客户端观察,不会停止容器。随后读取:
docker inspect dt10-oom --format 'Exit={{.State.ExitCode}} OOMKilled={{.State.OOMKilled}}'
docker logs --tail 20 dt10-oom
在符合实验前提的环境中,预期看到内存上升后容器被终止,常见为 137 且 OOMKilled 为 true。若只出现 Python MemoryError 或限制未生效,应按实际结果检查运行时和内核支持,不能把预期当实测。
实验结束后只删除 dt10-oom。不要为复现问题去关闭宿主机的 OOM 保护机制。
五、修复实践:容量与应用配置要一起看
若证据表明合理业务峰值超过限制,可以评估主机容量后增加容器内存。例如 docker update --memory=512m --memory-swap=512m api 会调整目标容器的相关限制,但 512 MiB 只是示例,不是通用推荐值;调整前确认应用需求、主机余量及平台支持。
若内存持续增长不回落,应继续查泄漏、缓存上限、批处理大小或并发配置。加内存可能只是延迟下一次失败。Java 等运行时还要让堆、非堆和本地内存合计留有余量。
如果由 Compose 管理,将经过评估的内存设置写回部署文件,避免下次重建丢失;运行时修改只是当前容器状态,不是完整的配置管理。
若确认是停止超时后的强杀,修复方向应是信号处理、优雅退出和停止宽限期,而不是加内存。
六、验证与总结
以接近故障时的业务负载观察内存峰值、请求延迟、重启次数和内核日志。空载运行五分钟没有退出,不能证明高峰问题已经解决。
这类故障的判断公式不是“137=OOM”,而是“退出状态 + OOM 标记 + 内核/平台记录 + 资源趋势”。证据确认哪条链路,再选择应用优化、容量调整或停止流程修复。