


面向初级运维,使用 Linux 节点和稳定 Kubernetes API。命令按 Bash 编写。本文为教学故障场景,日志及结果为示意,不冒充生产实测;执行前确认 context、命名空间和权限。
一、遭遇情况:Pod 一直重启,当前日志却很少
应用发布后容器反复退出,重启次数不断增加,STATUS 显示 CrashLoopBackOff。有人马上删除 Pod,新 Pod 又进入相同循环,而前一次的现场更难找了。
本篇场景是 Deployment 的启动命令错误,主进程每次执行完一条失败分支就退出。控制器重建或 kubelet 重启容器,都不会自动修正 Pod 模板里的同一错误。
二、原因分析:BackOff 描述的是重试节奏
CrashLoopBackOff 不是应用异常的具体名称,而是容器持续失败后退避重启的展示信息。可能的原因包括配置错误、依赖不可用、进程正常结束但不符合工作负载类型、探针终止或 OOM。
一个 Pod 里还可能有多个业务容器和初始化容器。必须确认哪一个失败,不能把 sidecar 的日志当作主应用证据,也不能用主容器日志解释 initContainer 尚未完成的问题。
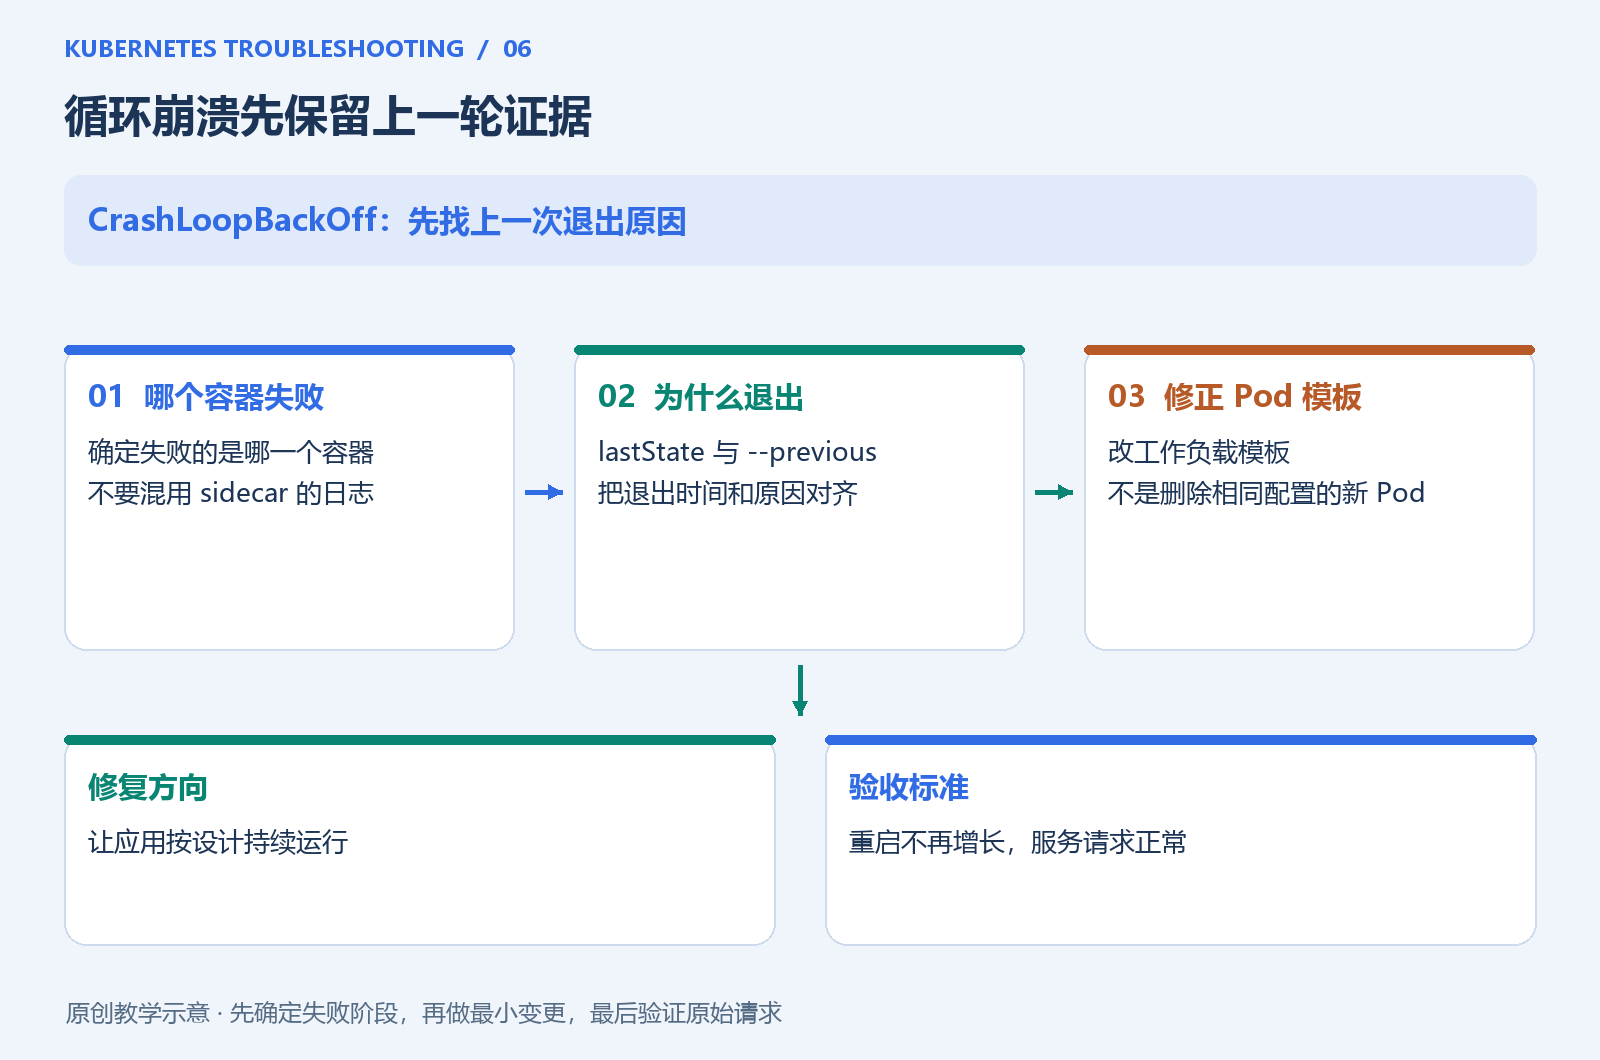
三、排查思路:当前状态与上一轮日志一起读
kubectl describe pod 目标Pod -n 目标命名空间
kubectl get pod 目标Pod -n 目标命名空间 -o jsonpath='{.status.containerStatuses}{"\n"}'
kubectl logs 目标Pod -n 目标命名空间 -c 容器名 --tail=100 --timestamps
kubectl logs 目标Pod -n 目标命名空间 -c 容器名 --previous --tail=100 --timestamps
查看 lastState.terminated 中的 reason、exitCode 和时间,与 Events、日志相互印证。--previous 获取上一容器实例日志,不是同名旧 Pod 的无限历史;若根本没有上一实例、日志已轮转或 Pod 被替换,查询可能没有结果。
退出码 0 也可能重启,例如 Deployment 中的一次性命令执行完毕,容器重启策略仍要求继续运行。137 需结合 OOMKilled 和资源证据,不能一律归因内存。
四、实践:创建一个会主动退出的错误命令
保存 kt06-crash.yaml:
apiVersion: v1
kind: Namespace
metadata:
  name: kt06
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  namespace: kt06
spec:
  replicas: 1
  selector:
    matchLabels:
      app: crash-demo
  template:
    metadata:
      labels:
        app: crash-demo
    spec:
      containers:
        - name: web
          image: busybox:1.37
          command: ["sh", "-c"]
          args:
            - "echo 'startup failed: demonstration command exits' >&2; exit 1"
kubectl apply -f kt06-crash.yaml
kubectl get pods -n kt06
kubectl describe pod -n kt06 -l app=crash-demo
容器预期反复以 1 退出。由于观察时机不同,可能先看到 Error 或短暂 Running,再看到 CrashLoopBackOff。选出实际 Pod 名后读取上一轮:
pod_name=$(kubectl get pod -n kt06 -l app=crash-demo -o jsonpath='{.items[0].metadata.name}')
kubectl logs "$pod_name" -n kt06 -c web --previous --tail=20
至少发生一次重启后,预期看到演示错误信息。不要为了出现这个状态而反复删除 Pod,那只会重新开始相同过程。
五、修复实践:让实际服务在前台运行
这个实验使用 BusyBox 的 HTTP 服务,把错误的 args 替换为前台服务命令:
kubectl patch deployment web -n kt06 --type=strategic -p '{"spec":{"template":{"spec":{"containers":[{"name":"web","args":["mkdir -p /www; echo service-ok > /www/index.html; exec httpd -f -p 8080 -h /www"]}]}}}}'
kubectl rollout status deployment/web -n kt06 --timeout=120s
kubectl logs deployment/web -n kt06 --tail=20
BusyBox HTTP 服务不一定输出访问日志,因此日志为空不代表失败。可以在独立终端执行:
kubectl port-forward deployment/web -n kt06 18096:8080
保持该命令运行,在本机另一终端请求 curl --max-time 5 http://127.0.0.1:18096/,预期得到 service-ok。port-forward 是诊断通道,不证明 Service 或集群网络路径正常。
六、需要进一步分支判断的情况
若上一轮日志指向探针失败,检查第 8 篇的探针定义;若为 OOMKilled,看第 7 篇;若依赖数据库尚未就绪,则查初始化与连接重试。增加一个 sleep infinity 可能让容器看起来不再重启,却把真正服务停止的问题隐藏起来。
如果这是一次性计算任务,应考虑 Job 等合适的工作负载,而不是为了让 Deployment “保持绿色”不断运行已经结束的任务。
七、验证与总结
修复后观察新 Pod 的重启次数是否持续增加,核对服务响应和部署模板。新 Pod 从 0 开始计数并不自动证明旧故障已经消失,需要持续观察。
正确顺序是:找出失败容器 → 保留 lastState 和上一轮日志 → 确认退出机制 → 修模板 → 验证新副本。删除 Pod 是可能的操作手段,不是原因分析。