
本篇是《Prometheus 从入门到生产实践》第 12 / 24 篇。配置以文中版本与环境前提为准,实验和故障均为教学场景。完整程序、配置及校验范围见配套实验包。
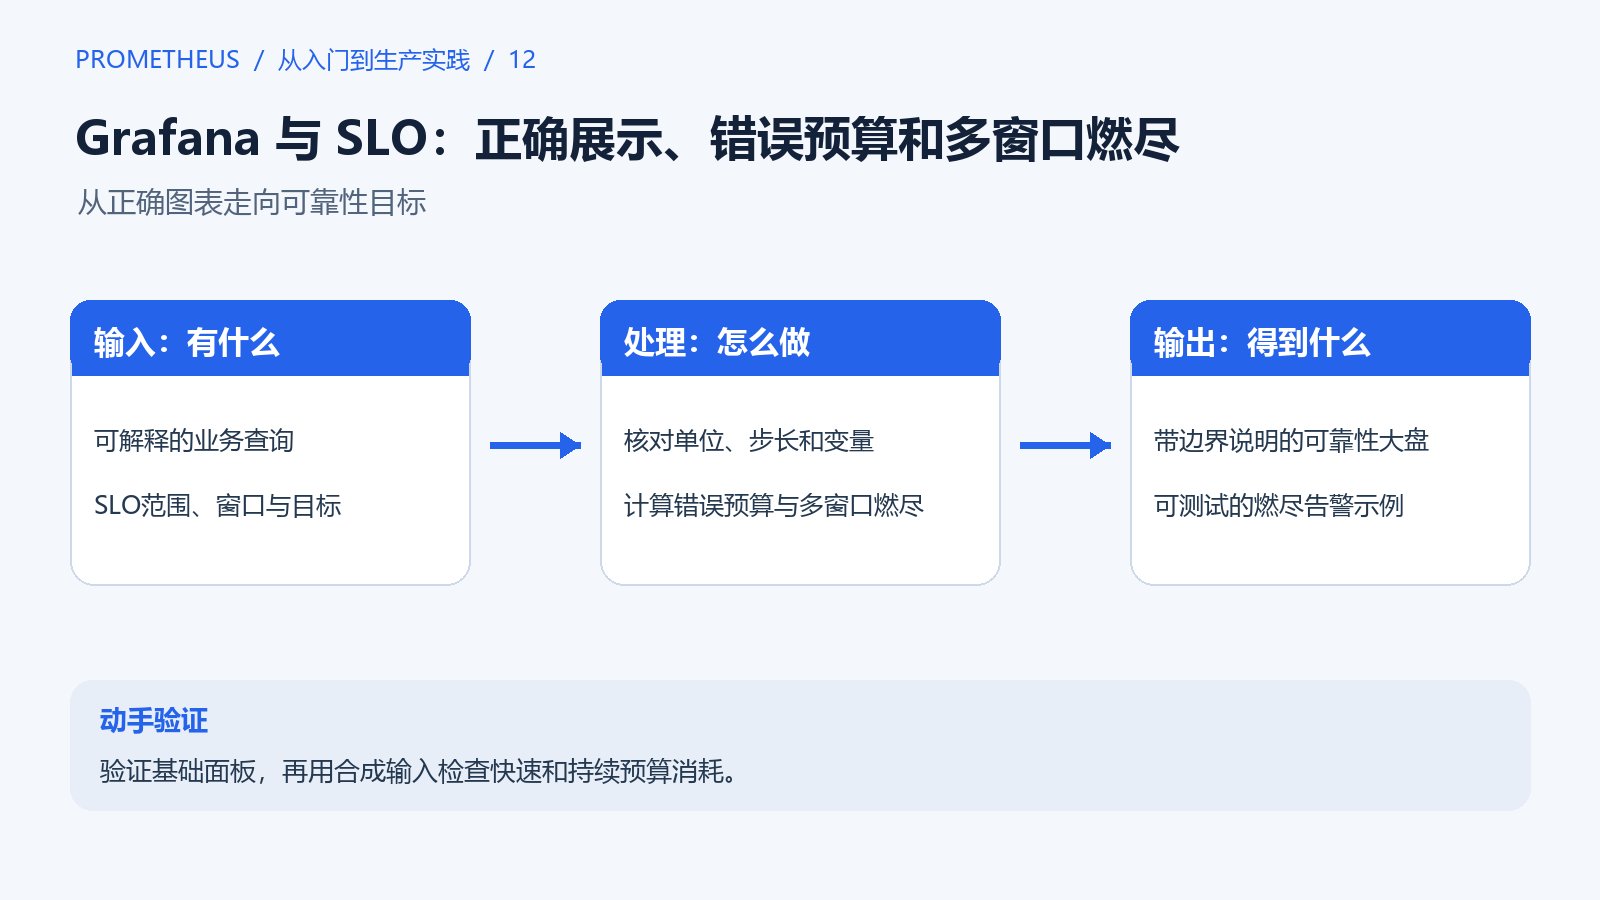
把指标画出来只是第一步。一个可用的大盘应该让人知道当前有多少流量、失败了多少、延迟如何、数据是否可信;SLO 则进一步回答这些结果是否满足用户体验目标。本篇把展示和可靠性判断连接起来。
1. 先确认 Grafana 从哪里连接 Prometheus
共享实验的 Prometheus 位于本机 19090,demo 位于 19100。如果 Grafana 也在同一主机网络环境,可以将数据源指向 http://127.0.0.1:19090。
如果 Grafana 运行在容器里,127.0.0.1 指 Grafana 容器自身,不能因为浏览器能打开 Prometheus 就假定数据源也能连。应使用 Grafana 服务端所在环境可达的地址,例如同一容器网络中的 Prometheus 服务名与其容器监听端口。
保存数据源后先做连接检查,再在 Explore 运行 up{job="demo"}。排障时把数据源连接问题和 PromQL 空结果分开。
2. 做四块能解释业务的大盘
| 面板 | 查询思路 | 单位与注意点 |
|---|---|---|
| 请求速率 | sum(rate(ops_demo_requests_total{job="demo"}[5m])) |
requests/s,不是累计次数 |
| 5xx 比例 | 同范围错误速率除以总速率 | 0~1 比例,Grafana 选对应百分比单位 |
| P95 延迟 | 第 9 篇的聚合 bucket 查询 | 输入单位为秒,面板也按秒处理 |
| 抓取状态 | up{job="demo"} |
区分 0、1 与无数据 |
给每块面板写上窗口、聚合范围和无数据语义。不要让 panel 标题写“每秒请求”,表达式却使用原始 counter。
秒与毫秒也要只转换一次。输入是 0.2 秒,可以让单位自动显示为 200ms;如果表达式已经乘了 1000,就应把面板单位设置为毫秒,而不是再按秒格式化。
3. 查询步长、窗口和变量不能靠界面猜
Grafana 的范围查询会选择 step,rate 的窗口是另一项设置。数据源的抓取间隔与面板 min step 等配置应对应实际情况,而不是任意填一个很小数字让曲线“更细”。
Grafana 提供 $__rate_interval 宏辅助选择 rate 窗口。下面属于 Grafana 编辑器语法,宏需要先由 Grafana 展开,不能原样交给 Prometheus API:
sum by (route) (
  rate(ops_demo_requests_total{job=~"${job:regex}"}[$__rate_interval])
)
job 变量可从指标的 job 标签取值;多选时使用明确的正则格式化。重复面板、多选变量和“全部”范围会放大查询数量,面板越多越需要关注资源开销。查询编辑器机制见 Grafana Prometheus 文档。
4. SLI、SLO 与错误预算是什么关系
SLI 是测量服务表现的指标;SLO 是在指定窗口内希望达到的目标。这里选择“符合范围的请求中,非 5xx 请求比例”为可用性 SLI,目标为滚动 30 天达到 99.9%。这只是教学定义,真实业务可能还需要计入超时、网关错误和取消请求。
允许的坏请求比例是 1 - 0.999 = 0.001,即 0.1%。这是按请求数定义的预算,不能直接等同为任意情况下固定多少分钟停机;请求流量并不总是均匀。
若应用停止,客户端根本没把请求计入 counter,单靠应用内部错误率可能看起来很好。因此 SLI 的测量位置和覆盖范围要与用户体验对应,采集链路和外部探测也需要单独监控。
5. 燃尽率把异常转换成预算消耗速度
燃尽率可以写成“当前坏请求比例 / 允许坏请求比例”。当当前错误率为 1%,而允许值为 0.1%,燃尽率就是 10 倍。
快的长窗口与短窗口同时超标,可以减少对陈旧故障或瞬时尖峰的误判。例如滚动 30 天的教学设计:
| 类别 | 长窗口与短窗口 | 燃尽率阈值 | 预算含义近似 |
|---|---|---|---|
| 快速消耗 | 1h 与 5m | 14.4 倍 | 该速度持续一小时约消耗 2% 的 30 天预算 |
| 持续消耗 | 6h 与 30m | 6 倍 | 该速度持续六小时约消耗 5% 的预算 |
这些是用于说明原理的设计起点,不是所有系统通用的阈值。窗口、流量、值班响应时间和业务容忍度都应参与决策。方法背景见 Google SRE 的 SLO 告警实践。
6. 规则如何落地
配套 a-slo.rules.yml 包含四个错误率窗口和两条燃尽告警,属于可选扩展,需要明确加入 rule_files 并按流程检查、重载才会生效。为避免与第 11 篇记录名称冲突,使用单独的 ops_demo_slo_bad 记录名。这份规则假设固定的 200、500 counter 已初始化输出;不满足时先应用第 10 篇的明确基线策略,不能把缺失直接当健康。
groups:
  - name: demo-slo-availability
    interval: 1m
    rules:
      - record: job_route:ops_demo_slo_bad:ratio5m
        expr: |
          sum by (job, route) (rate(ops_demo_requests_total{job="demo",code=~"5.."}[5m]))
          /
          sum by (job, route) (rate(ops_demo_requests_total{job="demo"}[5m]))
      - record: job_route:ops_demo_slo_bad:ratio1h
        expr: |
          sum by (job, route) (rate(ops_demo_requests_total{job="demo",code=~"5.."}[1h]))
          /
          sum by (job, route) (rate(ops_demo_requests_total{job="demo"}[1h]))
      - record: job_route:ops_demo_slo_bad:ratio30m
        expr: |
          sum by (job, route) (rate(ops_demo_requests_total{job="demo",code=~"5.."}[30m]))
          /
          sum by (job, route) (rate(ops_demo_requests_total{job="demo"}[30m]))
      - record: job_route:ops_demo_slo_bad:ratio6h
        expr: |
          sum by (job, route) (rate(ops_demo_requests_total{job="demo",code=~"5.."}[6h]))
          /
          sum by (job, route) (rate(ops_demo_requests_total{job="demo"}[6h]))
      - alert: DemoSLOBurnFast
        expr: |
          (job_route:ops_demo_slo_bad:ratio1h > 14.4 * 0.001)
          and on (job, route)
          (job_route:ops_demo_slo_bad:ratio5m > 14.4 * 0.001)
          and on (job, route)
          (sum by (job, route) (rate(ops_demo_requests_total{job="demo"}[5m])) > 0)
        for: 2m
        labels:
          severity: critical
          slo: availability-99_9
        annotations:
          summary: '错误预算快速消耗:{{ $labels.job }} {{ $labels.route }}'
          description: '1h 与 5m 窗口同时超过 14.4 倍预算燃尽率,请核对请求错误、数据完整性和用户影响。'
      - alert: DemoSLOBurnSlow
        expr: |
          (job_route:ops_demo_slo_bad:ratio6h > 6 * 0.001)
          and on (job, route)
          (job_route:ops_demo_slo_bad:ratio30m > 6 * 0.001)
          and on (job, route)
          (sum by (job, route) (rate(ops_demo_requests_total{job="demo"}[30m])) > 0)
        for: 15m
        labels:
          severity: warning
          slo: availability-99_9
        annotations:
          summary: '错误预算持续消耗:{{ $labels.job }} {{ $labels.route }}'
          description: '6h 与 30m 窗口同时超过 6 倍预算燃尽率,请安排调查并核对通知路由。'
长短窗口用 and on(job,route) 对齐同一个业务范围。额外的有流量条件防止把未定义比例当作有效错误率,但“只要有一个请求”未必适合低流量系统。是否增加最小请求量,或改用事件计数与外部探测,要按业务定义。
for 的具体状态和通知链路会在后续章节展开。这里的 critical、warning 只是标签,只有 Alertmanager 路由或值班平台消费它们后,才会改变实际通知行为。
7. 规则测试和数据覆盖分别验证
a-slo.test.yml 用八小时的合成输入分别测试持续 6% 失败与健康流量,预期前者在选定检查时刻有两条 firing 告警,后者没有。运行方式:
promtool check rules a-slo.rules.yml
promtool test rules a-slo.test.yml
这些命令需要在具备 promtool 的环境实际执行并记录结果;教学文件本身不证明测试已经通过。合成输入验证数学和状态,不能证明生产采集完整。
刚启动十分钟,[6h] 仍可能基于现有样本返回值;这不表示它已经覆盖完整六小时。30 天合规报告同样需要相应的保留期、稳定的测量位置和缺失数据处理,不能只把查询窗口改长就宣布达标。
8. 验收与练习
先用共享实验产生正常、错误和慢请求,核对四块基础面板;再用合成数据验证 SLO 规则,而不是在真实服务上制造故障去等六小时。
最后给这份大盘写一段使用说明:SLI 统计什么、不统计什么,单位是否转换,数据源从哪连接,空数据如何解释,告警发给谁。广度来自把展示、采集和通知串起来;深度来自每个数字都能追溯到清晰的定义。
上一篇:查询性能与记录规则:从定位开销到合成测试 · 系列目录 · 下一篇:告警规则进阶:持续时间、稳定标签、缺失数据与单元测试