
本篇是《Prometheus 从入门到生产实践》第 17 / 24 篇。配置以文中版本与环境前提为准,实验和故障均为教学场景。完整程序、配置及校验范围见配套实验包。
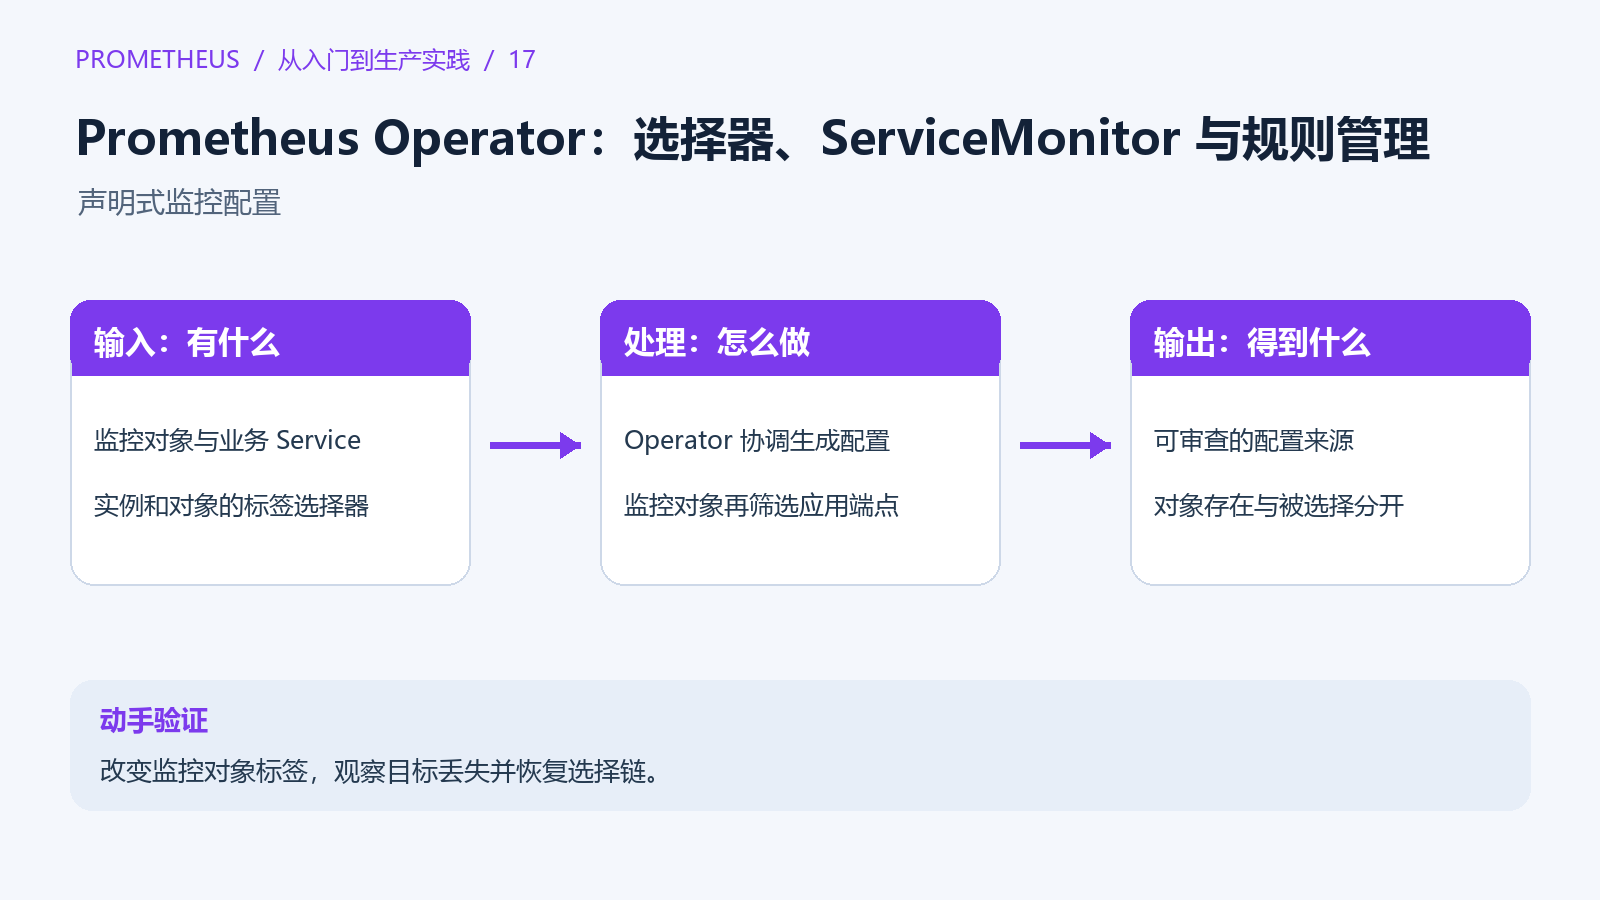
直接维护一份 prometheus.yml 可以理解原理,但集群里有很多团队时,每个团队都改同一文件会增加协调成本。Prometheus Operator 把一部分监控配置表示为 Kubernetes 资源,由控制器协调生成和部署。它改变的是配置管理方式,不会改变 PromQL 和抓取协议本身。
1. 先认识几个资源的职责
| 资源 | 主要描述什么 |
|---|---|
| Prometheus | 实例规格、选择哪些监控和规则对象、存储等 |
| ServiceMonitor | 通过 Service 选择后端端点怎样抓取 |
| PodMonitor | 直接选择 Pod 的指标端点 |
| PrometheusRule | recording 和 alerting 规则 |
| Alertmanager | Alertmanager 实例的运行规格 |
这些不是 Kubernetes 默认自带的全部资源,需要先安装兼容的 CRD 和 Operator 控制器。本篇使用已经安装并正常运行的测试 Operator;不提供任意版本的“一条 Helm 命令装全家桶”,因为 Chart、CRD、Operator 和 Prometheus 之间有独立的版本关系。
2. 最容易混淆的是两层选择
第一层:Prometheus 的 serviceMonitorSelector 选择 ServiceMonitor 自己的 metadata.labels,serviceMonitorNamespaceSelector 决定去哪些命名空间找它。
第二层:被选中的 ServiceMonitor 用自己的 selector 选择 Service 标签,用 namespaceSelector 选择业务 Service 所在命名空间。
所以给应用 Pod 加 monitoring: lesson,不会自动满足第一层;把 ServiceMonitor 放在了未被搜索的命名空间,也不会自动进入配置。API 定义见 Operator 资源参考。
3. 独立测试实例明确写选择器
下面仅供创建新的隔离测试实例参考,依赖第 16 篇的命名空间、应用和 ServiceAccount;已有监控栈请调整自己管理的实例,不直接叠建第二套:
# New isolated test instance only; requires compatible Operator/CRDs and chapter 16 RBAC.
apiVersion: monitoring.coreos.com/v1
kind: Prometheus
metadata:
  name: lesson
  namespace: monitoring-lab
spec:
  replicas: 1
  serviceAccountName: prometheus-discovery
  serviceDiscoveryRole: EndpointSlice
  retention: 6h
  serviceMonitorSelector:
    matchLabels:
      monitoring: lesson
  serviceMonitorNamespaceSelector:
    matchLabels:
      kubernetes.io/metadata.name: monitoring-lab
  podMonitorSelector:
    matchLabels:
      monitoring: lesson
  podMonitorNamespaceSelector:
    matchLabels:
      kubernetes.io/metadata.name: monitoring-lab
  ruleSelector:
    matchLabels:
      monitoring: lesson
  ruleNamespaceSelector:
    matchLabels:
      kubernetes.io/metadata.name: monitoring-lab
serviceDiscoveryRole 显式选 EndpointSlice,与前一篇授予的服务发现权限对应。旧 Operator 或 CRD 可能不认识该字段,先运行 kubectl explain prometheus.spec.serviceDiscoveryRole,并核对兼容版本。
示例 retention 只是短期教学取值,未配置持久卷,因此不承担生产数据持久性。真正部署还需要资源请求、持久卷、可用区、升级和备份策略,后面的存储与高可用章节会继续展开。
要特别区分空选择器 {} 与 null/省略的含义。当前 API 中,监控对象的空 label selector 可匹配全部对象,null 通常不选对象;命名空间选择器省略则通常限于当前命名空间。不要把一种字段的默认语义套到另一种字段,Chart 也可能在渲染时补上条件。
4. 让 ServiceMonitor 找到指定指标端口
沿用第 16 篇的 demo-metrics Service,Service 自身有 app=demo 标签,端口名为 metrics。创建:
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: demo
  namespace: monitoring-lab
  labels:
    monitoring: lesson
spec:
  namespaceSelector:
    matchNames: ['demo-lab']
  selector:
    matchLabels:
      app: demo
  endpoints:
    - port: metrics
      path: /metrics
      interval: 15s
      scrapeTimeout: 5s
这里 endpoints.port 填的是 Service 端口名 metrics,不是随便填写 Pod 端口数字,也不是容器名称。Service 的 targetPort 再把它映射到实际容器端口。
interval 和 scrapeTimeout 都属于这个采集端点,超时不得超过相应间隔。抓取路径默认是什么、是否 HTTPS、有无认证,都要与真实应用一致,Operator 不会替应用实现 /metrics。
PodMonitor 是可选替代:
# Optional alternative to ServiceMonitor; do not enable both for the same demo.
apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
  name: demo-direct
  namespace: monitoring-lab
  labels:
    monitoring: lesson
spec:
  namespaceSelector:
    matchNames: ['demo-lab']
  selector:
    matchLabels:
      app: demo
  podMetricsEndpoints:
    - port: metrics
      path: /metrics
      interval: 15s
初次实验只启用一种方式。对同一个应用同时创建两种监控对象,可能造成重复采集;生成 job 名通常也不同,不能把它当成毫无成本的双保险。
5. 规则也要经过选择才能被加载
保存:
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: demo
  namespace: monitoring-lab
  labels:
    monitoring: lesson
spec:
  groups:
    - name: lesson-demo
      rules:
        - alert: DemoKubernetesTargetDown
          expr: up{namespace="demo-lab",service="demo-metrics"} == 0
          for: 2m
          labels:
            severity: warning
          annotations:
            summary: 'Kubernetes 抓取失败:{{ $labels.instance }}'
这个规则只匹配 ServiceMonitor 生成的 Service 维度,不适用于上面的 PodMonitor 替代方案。Operator 可能生成与本机实验不同的 job,所以这里不硬编码 job=demo,应先查询 up 的实际标签。
PrometheusRule 的 metadata.labels 必须被 ruleSelector 选中。对象已存在、Prometheus 规则页能找到、规则健康且产生预期结果,是三个不同检查点。
Operator 控制器需要读取 CRD 与协调工作负载的权限;Prometheus Pod 自己则需要目标发现与抓取权限。两者的 ServiceAccount 和 RBAC 不能相互替代,参考 Operator RBAC 指南。
6. 为什么不能直接修改生成的配置
Operator 会持续协调期望状态。手工修改生成的 Secret 或容器文件,可能很快被覆盖,还会使线上内容和声明式来源不一致。
通过 CR、受控附加配置或对应 Chart values 管理变更。使用 kube-prometheus-stack 等 Chart 时,serviceMonitorSelectorNilUsesHelmValues 等模板选项可能补入 release 标签,最终以渲染后的 Prometheus 对象为准,不凭 values 文件名字猜测。
查看现有资源:
kubectl -n monitoring-lab get prometheus lesson -o yaml
kubectl -n monitoring-lab get servicemonitor demo -o yaml
kubectl -n monitoring-lab get prometheusrule demo -o yaml
7. Helm、CRD 与控制器的升级边界
一次监控栈升级可能同时涉及模板、资源定义、控制器镜像、Prometheus 镜像和规则包。它们不是一个不可区分的版本号。新增字段能被模板渲染出来,也不保证集群已安装的资源定义接受它,更不保证旧控制器会按新语义处理。
发布前先查看当前资源定义和已部署版本,再对照兼容说明及发行记录。测试环境使用服务端校验可以发现未知字段和部分结构问题,但仍需等待控制器协调,并验证真实目标。不要把客户端能够生成合法的通用 YAML,当成集群已经支持监控语义的证据。
Helm 管理的实例应保留可复现的值文件和渲染结果。紧急手工修改资源以后,还要把修复回写到正式配置来源,否则下一次升级可能把修复覆盖。回滚同样要区分模板回退、资源定义兼容和持久数据兼容,不能只看到旧镜像启动就宣称完成。
8. 配置对象也是团队之间的接口
在多团队环境中,可以约定谁能创建监控对象、允许抓取哪些命名空间、必须带哪些归属标签,以及采集间隔和样本规模的默认限制。这样应用团队能自主交付指标,又不会因为一个对象无意扩大到全群集范围。
一个常见问题是监控对象选择了标签过宽的 Service:业务服务和管理服务都匹配,后端端口又不一致。排查时应核对选中的对象清单和最终端口,而不是只看对象名是否叫 demo。指标成功出现后,还要观察是否出现两份相同业务请求计数,避免重复抓取使聚合翻倍。
规则资源也需要评审。定义了一个能够运行的表达式,并不等于查询成本可接受、告警标签稳定或接收团队正确。控制器负责协调,不负责替团队完成业务验收。把规则单测、范围检查和配置审查放进发布流程,才是声明式管理能长期带来收益的地方。
诊断生成配置时应留意认证内容和内部地址,按需查看,不要把完整 Secret 或包含凭据的配置复制进公开问题记录。保留对象名称、版本、选择器和相关错误,通常已足以建立最小复现。
9. 按选择链排障与验收
若目标没出现,依次检查 CRD 是否存在、控制器是否接受资源、监控对象标签和命名空间是否被实例选择、Service 标签是否匹配、命名端口是否存在、EndpointSlice 是否有后端。
再检查 Operator 事件与日志,查找被拒绝的对象;不要直接把所有 selector 改成 {} 来“试通”,因为这会改变监控范围。常见拒绝与排查方式见 官方排障指南。
最后在实例 Service Discovery、Targets 和 Rules 页面验证生成结果。练习只改 ServiceMonitor 的 monitoring 标签,观察对象存在但不被实例选择的现象,再恢复标签。理解两层选择和控制器协调,比记住几个 YAML 名称更能帮助你维护集群监控。
上一篇:Kubernetes 原生采集:Pod、EndpointSlice 与最小 RBAC · 系列目录 · 下一篇:全链路排障:从 Targets 到查询、规则与通知