


本篇是《Python 从入门到初级》第 12 / 20 篇。示例使用 Python 3.12 兼容语法,完整目录结构与数据见配套源码包。
日志经常包含时间、级别和一段消息。Python 可以把这些文字提取成字段,统计错误数量和时间范围。本篇把正则表达式、datetime 和 Counter 用在一个小型日志分析程序中。
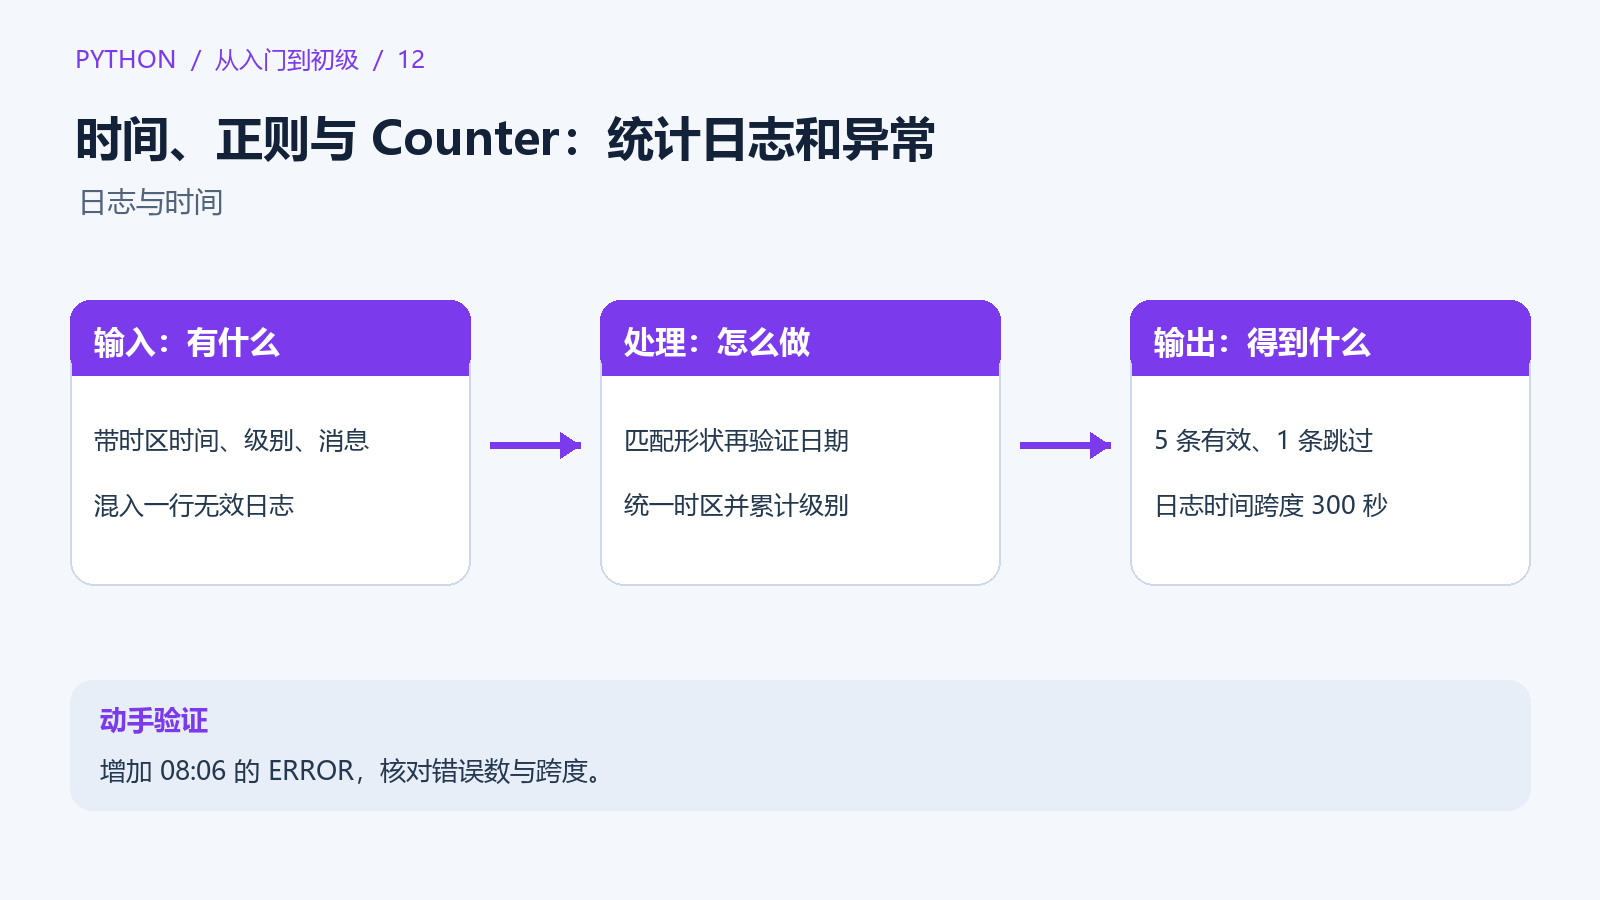
1. 先给日志定义一个可解释的格式
在 data/app.log 放入教学数据:
2026-10-31T08:00:00+00:00 INFO service started
2026-10-31T08:01:00+00:00 ERROR request failed
2026-10-31T08:03:00+00:00 WARNING queue high
this is not a structured log
2026-10-31T08:04:00+00:00 INFO request recovered
2026-10-31T08:05:00+00:00 ERROR database timeout
约定每条结构化记录由“带时区的 ISO 时间、INFO/WARNING/ERROR 级别、消息”组成,其中故意混入一行不符合格式的文字。
程序要统计有效记录,也要记录跳过了几行。不符合约定的数据如果被静默丢弃,就很难知道报告究竟覆盖了多少内容。
2. 正则负责匹配形状,不代替所有验证
\S+ 表示一段非空白字符,\s+ 表示至少一个空白,(?P<time>...) 给匹配结果命名。fullmatch() 要求整行符合模式。
正则能提取一个“长得像时间的字段”,但不保证它真的是合法日期,所以还要交给 datetime 解析。简单字符串拆分已经足够的场景,不必强行写复杂正则。
模式语义见 re 文档。
3. 完整示例:日志级别和时间跨度
运行 python lesson12.py:
import re
from collections import Counter
from datetime import datetime, timezone
from pathlib import Path

BASE = Path(__file__).resolve().parent
pattern = re.compile(r"(?P<time>\S+)\s+(?P<level>INFO|WARNING|ERROR)\s+(?P<message>.*)")
counts = Counter()
times = []
skipped = 0
for line in (BASE / "data" / "app.log").read_text(encoding="utf-8").splitlines():
    match = pattern.fullmatch(line)
    if match is None:
        skipped += 1
        continue
    try:
        timestamp = datetime.fromisoformat(match["time"])
        if timestamp.tzinfo is None:
            raise ValueError("日志缺少时区")
    except ValueError:
        skipped += 1
        continue
    counts[match["level"]] += 1
    times.append(timestamp.astimezone(timezone.utc))

print("级别统计:", dict(sorted(counts.items())))
print("跳过行数:", skipped)
if times:
    print("时间跨度(秒):", int((max(times) - min(times)).total_seconds()))
print("用户名格式是否符合约定:", re.fullmatch(r"[A-Za-z_][A-Za-z0-9_]{2,15}", "alice_01") is not None)
预期 INFO 为 2 条,ERROR 为 2 条,WARNING 为 1 条,跳过 1 行;最早与最晚有效日志相差 300 秒。用户名 alice_01 符合示例约定。
输出中的分类顺序只是为了稳定展示,不代表日志发生顺序。统计程序使用最早和最晚时间计算跨度,因此不要求文件本来已经按时间排序。
4. 时间为什么要带时区
2026-10-31T08:00:00+00:00 的 +00:00 说明时区偏移。只看到 08:00,无法判断它和另一台机器的 08:00 是否同一时刻。
程序要求时间带时区,并转换到 UTC 后比较。没有时区的值被视为不符合这份数据约定,而不是根据运行机器的时区随意猜测。
对 Python 而言,带时区和不带时区的 datetime 对象有不同的比较约束。相关机制见 datetime 文档。
5. Counter 为什么适合计数
Counter 来自标准库 collections,可以像字典那样使用,但适合累计出现次数。counts[level] += 1 就是在为某个级别增加一次计数。
它也可以统计商品分类、文件扩展名或单词。先理解前面用 get(key, 0) 累加的写法,再使用 Counter,会更清楚这个工具替你简化了哪一步。可查 collections 文档。
6. 常见误区和练习
不要因为日期字符串看起来相同长度,就直接假定任意格式都能按字典序比较。格式、偏移和精度不同可能破坏这个假设。
正则中的 .、* 等有特殊含义,Python 字符串又有转义规则,通常用 r"..." 原始字符串让模式更容易阅读。正则仍按自己的规则解释反斜杠。
练习:加一行 2026-10-31T08:06:00+00:00 ERROR cache unavailable。预期 ERROR 增为 3,跨度变为 360 秒。再增加一行缺少时区的时间,预期跳过行数增加,而不是混入时间计算。