
本篇是《Prometheus 从入门到生产实践》第 19 / 24 篇。配置以文中版本与环境前提为准,实验和故障均为教学场景。完整程序、配置及校验范围见配套实验包。
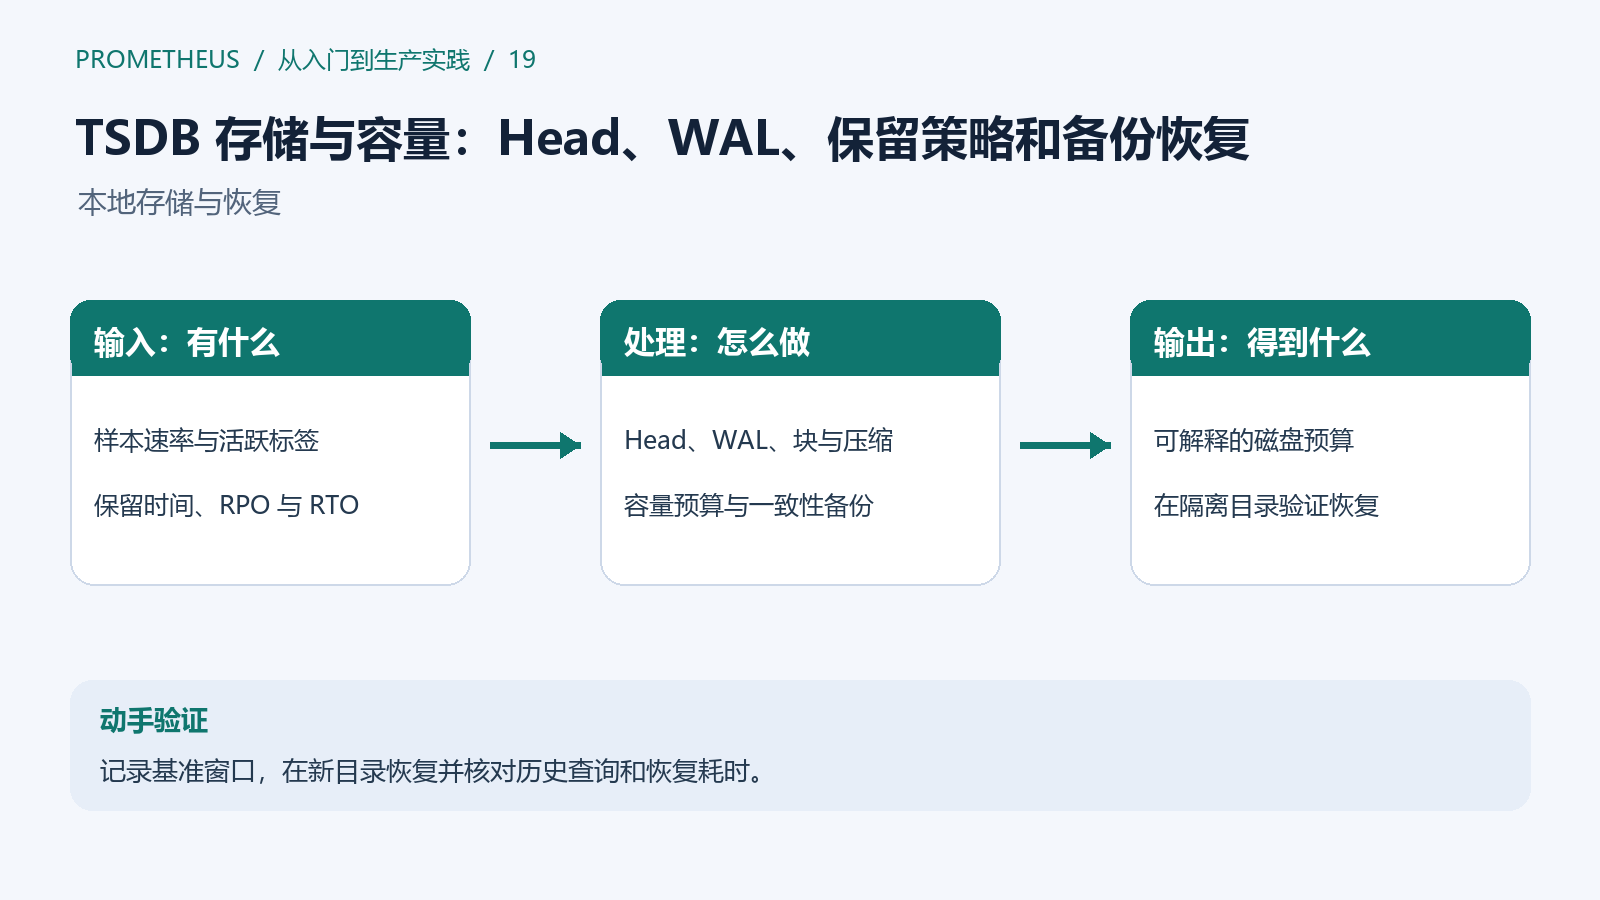
Prometheus 的数据不是一堆可以随意删改的文本文件。进入生产阶段,需要理解最近的数据在哪里、历史块怎样生成、保留策略删什么,以及备份恢复能够覆盖哪段时间。否则“磁盘满了就删 WAL”或“复制目录就算备份”都可能把故障变成数据损失。
1. 沿一批样本认识 Head、WAL 和 Block
新样本进入最近活跃数据区域 Head,WAL 为崩溃后的重放提供恢复依据;Head 中的部分 chunk 还会以磁盘映射形式保存。到达相应条件后,数据写成不可变时间块,再由 compaction 合并。块通常包含 metadata、索引和 chunks,删除记录还可能通过 tombstones 表达,而不立即重写全部历史。
初始持久块一般覆盖约两小时,后续会合并为更大的块。“两小时”不是每个查询只能看两小时,也不是容器一重启就丢掉最近两小时。真正恢复能力取决于数据目录、WAL、文件系统和关闭方式。存储布局应结合所用版本的 Storage 文档 阅读。
WAL 解决本机崩溃恢复,不是无限日志、跨机器复制或异地备份。宿主机磁盘整体丢失时,它也可能一起丢失;WAL 重放还会使重启过程持续一段时间,不能只因界面暂时未就绪就反复杀进程。
2. 数据目录要独立、持久而且只有一个写入者
实验实例使用独立目录:
prometheus --config.file=prometheus.yml \
  --storage.tsdb.path=./data/prometheus \
  --web.listen-address=127.0.0.1:19090
容器化时,要把该目录持久化到正确挂载位置;Kubernetes 中还要检查 PVC 生命周期、存储类和磁盘性能。把配置挂载成功,不代表 TSDB 数据也已经持久化。
不要让两个 Prometheus 进程共用同一个 TSDB 目录,双实例高可用采用各自独立存储。也不要为了绕过占用错误随意关闭锁文件。存储介质需要适合 TSDB 的文件系统语义;官方不支持把普通 NFS/EFS 共享目录视为可靠的本地 TSDB 替代品。
3. 用样本速率估算,不只看目标数量
假设活跃序列约 20 万,每 15 秒采样一次,粗略摄入速率为:
200000 / 15 ≈ 13333 样本/秒
15 天样本量 ≈ 13333 × 86400 × 15 ≈ 172.8 亿
若压缩块按约 2 字节/样本估算,约 34.6 GB(十进制)
这是传统标量样本的初始规划,不是最终磁盘承诺。它还没有完整覆盖索引、标签、WAL、Head chunks、压缩临时空间、快照、文件系统和增长余量。直方图尤其原生直方图的大小与分布有关,不能一律按这个系数套算。
更稳妥的做法是让代表性流量运行一段时间,记录每天生成的块大小、活跃序列、样本速率和磁盘峰值,再反推保留周期。用实际基数与每天新生序列校正估算,比“每台主机分配一块固定容量”更接近真实需求。
4. 时间保留和大小保留分别限制什么
常见 3.x 版本可通过启动参数设置,例如保留 15 天,并将大小预算留在磁盘容量以内:
prometheus --config.file=prometheus.yml \
  --storage.tsdb.path=./data/prometheus \
  --storage.tsdb.retention.time=15d \
  --storage.tsdb.retention.size=40GB \
  --web.listen-address=127.0.0.1:19090
这是假设有更大可用磁盘的教学取值,不是通用生产建议。两种策略同时设置时,先触发的约束生效;大小控制主要通过删除持久块实现,不能把 WAL 或 Head 当成可以任意截断的部分。清理也有后台节奏,不保证到达阈值后瞬间释放空间。
较新版本已经将这些 retention flags 标记为弃用并提供 storage.tsdb.retention 配置。升级时先查看目标版本 prometheus --help 与 命令行文档,按该版本支持的方式迁移,不能把 latest YAML 字段直接复制到旧版本。
5. 备份要区分“有文件”和“能恢复”
在线运行时直接复制活跃目录,可能遇到文件增删和状态不一致。更清晰的路线是使用支持的 TSDB snapshot,或在受控停机、确认进程已退出后复制一致的数据目录。
Snapshot API 需要单独启用 admin API,因此只在受保护的管理入口使用。以下仅是已授权实验环境中的请求示例:
curl --fail --max-time 30 -X POST \
  'http://127.0.0.1:19090/api/v1/admin/tsdb/snapshot?skip_head=false'
成功返回快照名称不等于完成异地备份。快照仍在 TSDB 数据目录下,通常利用硬链接等机制保存块引用;需要按返回位置复制到独立介质,并把配置、规则、版本和校验信息另行保存。skip_head=true 可能排除尚未落成块的近期数据,应在 RPO 中明确这一点。API 条件见 TSDB Admin APIs。
6. 恢复演练的具体步骤
先选择一段已知查询窗口,记录某个目标的 up、请求量和时间范围;保存快照及相关配置。然后在独立机器或隔离目录中恢复,使用与备份相匹配、确认兼容的版本,从新端口启动。
验证顺序是:日志没有块加载和 WAL 错误,readiness 通过,历史窗口能查到预期序列,标签与原记录一致,新抓取可正常追加。最后测量总耗时,与预先约定的恢复目标比较。不要在未验证副本上覆盖正在使用的数据目录。
如果启动报告损坏,先保存现场并确定受影响的块或 WAL。直接删除这些内容会损失对应时间的数据,应当作为已经理解损失范围后的最后手段,而不是初级排障第一步。
7. 典型排查:保留期调短了,磁盘为什么仍然很满
设想一个教学故障:实例配置从十五天缩为七天,过了一会儿磁盘使用率仍然接近上限。先不要认定配置无效。第一步确认进程真正使用了新参数或配置,查看运行时状态和重载日志;第二步检查现有块覆盖的时间范围,确认是否已经达到可删除条件;第三步再区分块、WAL、Head chunks 和快照各占多少空间。
有些块跨越保留边界,需要整个块满足条件才会清理。压缩期间新旧块同时存在,也会出现临时峰值。如果之前保留了本机快照,即使原目录中的旧块被清理,快照的文件引用仍可能让磁盘空间无法释放。保留策略不是自动管理所有备份目录的总磁盘清洁器。
接下来要查样本输入是否增长:目标数没变,但应用新加了动态标签,也可能让新块持续增大。把当天摄入量、序列创建速度与发布记录对齐,再判断是清理节奏、快照保留还是数据规模发生变化。
只有确认备份已转移并能恢复、快照不再需要后,才按既定备份保留制度处理对应目录。若只知道一个目录很大却不知道它的作用,先保留现场并缩小问题范围。磁盘告警应在剩余空间还能支撑排查与恢复之前触发,而不是等到无法写入新样本才通知。
8. 本篇验收
为自己的实验实例画出“活跃数据、持久块、快照、独立备份”的位置;填一张样本速率、每日增长、保留时间、磁盘余量、RPO、RTO 表;在新目录完成一次恢复查询。能说清备份覆盖到哪个时刻、恢复需要多久,才形成存储运维闭环。
上一篇:全链路排障:从 Targets 到查询、规则与通知 · 系列目录 · 下一篇:高基数与性能治理:限制、查询成本和容量实验