
本篇是《Prometheus 从入门到生产实践》第 20 / 24 篇。配置以文中版本与环境前提为准,实验和故障均为教学场景。完整程序、配置及校验范围见配套实验包。
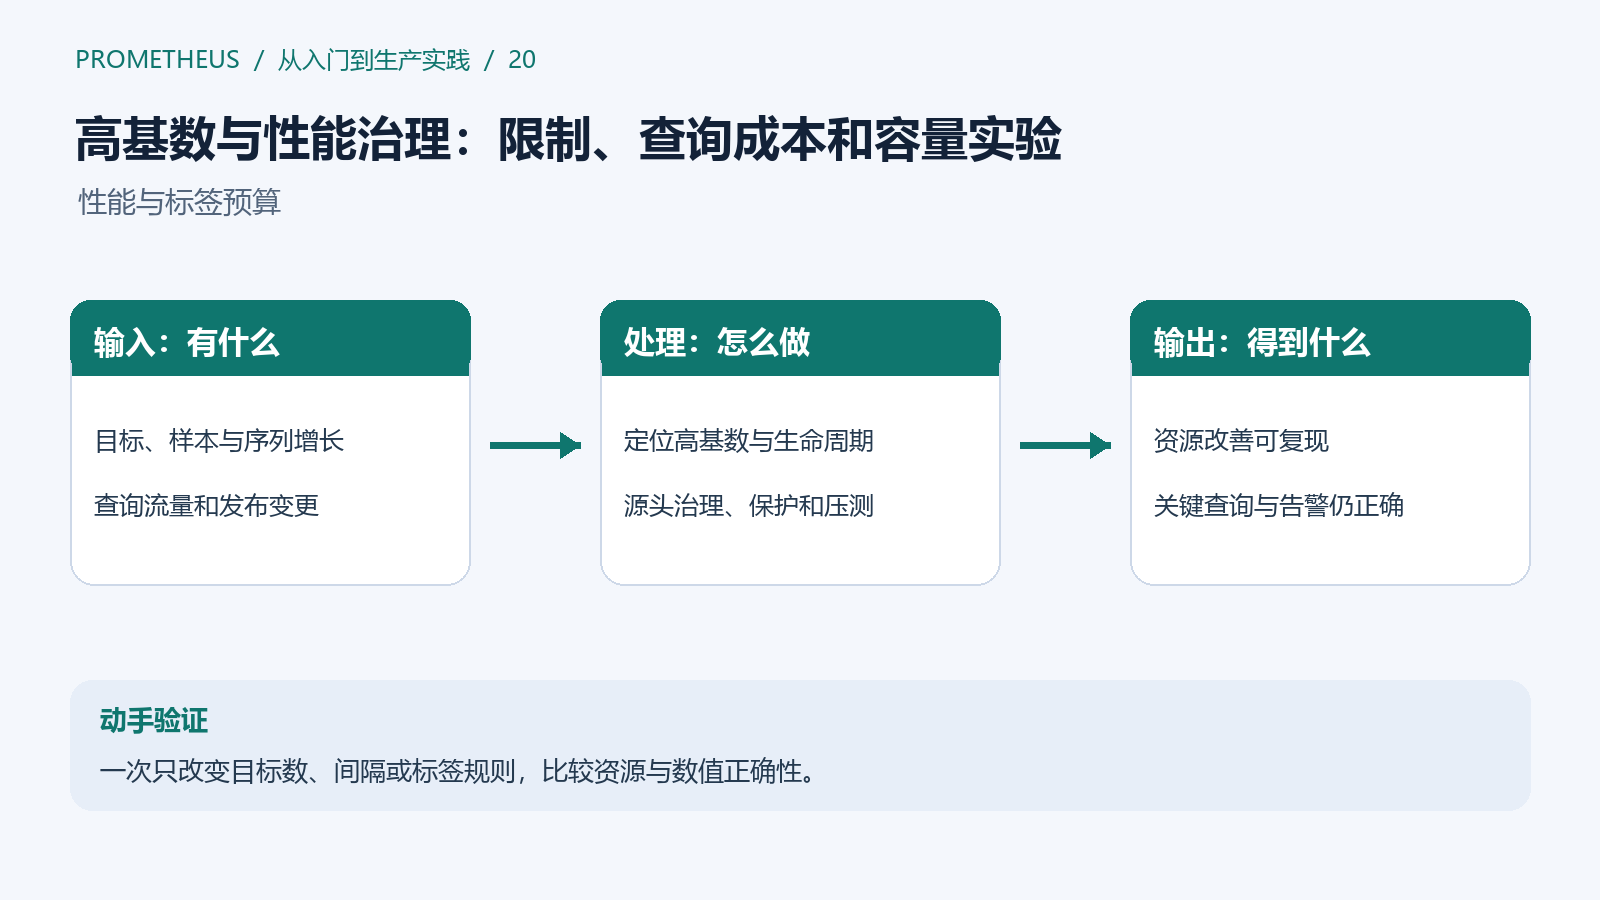
Prometheus 性能问题经常表现为内存增长、查询变慢、抓取超时,根因却可能是某个新标签、一次大规模服务发现或一张自动刷新的仪表盘。治理不能只靠增大内存,也不能把所有限制调得很低后把采集失败误认为“系统更轻了”。
1. 先把四种增长分开
目标数是要抓多少个地址;每个目标的样本数是一次响应有多少样本;活跃序列数是当前存在多少组指标与完整标签;序列 churn 则描述旧序列不断退出、新序列不断创建的速度。
例如 route 从 /orders/{id} 改成真实 URL,订单编号会不断产生新标签值。即使同时在线的请求不多,一天累计创建的序列也可能很大。request_id、user_id、原始 SQL、随机字符串通常不适合做指标标签,应进入日志或追踪系统。标签取舍原则可查 Metric and label naming 与 Instrumentation。
经典直方图还会把每组业务标签扩成 bucket、sum、count 多条序列。计算预算时不能只数一个指标名字。原生直方图能改变表示方式,但也不能让无限标签变得免费。
2. 先测量,建立同一时间线
观察活跃序列、序列新建速率、抓取样本数、进程内存、CPU 与查询负载,并与发布和服务发现变更时间对齐。可从实验实例查询:
prometheus_tsdb_head_series
rate(prometheus_tsdb_head_series_created_total[5m])
topk(10, scrape_samples_post_metric_relabeling)
这些自监控指标由实际版本决定,应先查看 Prometheus 自身 /metrics,并确保已配置抓取自身。scrape_samples_post_metric_relabeling 是每次抓取的结果,不是每秒吞吐,不能因为它是数字就随意套 rate。
再看 TSDB 状态 API 的标签与指标统计,但这类排查本身也有成本,不应在高压时对所有数据无限制扫描。把问题缩到某个 job、指标族或变更批次,通常比先执行全局大聚合更有效。
3. 在正确的阶段减少数据
最佳位置是源头:把动态 URL 归一化,删除无用维度,只启用确实需要的 collector。其次是在目标 relabel 阶段排除不应抓取的目标,再考虑 metric relabel 丢弃不需要的样本。
metric relabel 发生在响应已经抓取之后,因此不能节省 exporter 构造响应及网络传输的全部开销,也不会删除已经存下来的历史序列。删除某个标签还可能把原本不同的两条序列合并成相同身份,造成重复样本或错误语义;不要把 labeldrop 当成通用聚合。
4. 用采集限制保护实例,并理解失败语义
下面是一份独立实验配置,限制值只是演示。合并到实际配置前,先测量正常响应规模并给合理余量:
global:
  scrape_interval: 15s
  scrape_timeout: 10s

scrape_configs:
  - job_name: demo
    sample_limit: 5000
    label_limit: 20
    label_name_length_limit: 100
    label_value_length_limit: 200
    target_limit: 10
    static_configs:
      - targets: ['127.0.0.1:19100']
    metric_relabel_configs:
      - source_labels: [__name__]
        regex: 'ops_demo_debug_.*'
        action: drop
sample_limit 在 metric relabel 之后检查。超过限制时,通常是整次抓取失败,不是“安静地只保留前 5000 条”。标签数量或长度超限同样可能使抓取整体失败;target_limit 是 relabel 后每个 scrape 配置的目标限制,超限也不是自动选择最重要的前几个目标。
因此,限制需要配套 up、Targets 最近错误及样本规模观测。刚上线后出现 up=0,应区分真实连接问题和自己触发的采集保护。具体字段及实验性状态以所用版本的 scrape configuration 为准。
5. 查询慢,先问它读了多少数据
查询成本不只取决于返回的曲线数。一个最后只输出一条结果的 sum,也可能扫描大量序列和长时间样本;子查询、多层窗口和高分辨率 range query 会继续放大工作量。
先把时间缩短到几分钟,限定 job 与业务范围,再逐步扩大。对同一条表达式记录扫描范围、步长、耗时和错误,再决定是否需要 recording rule。仪表盘同时打开许多面板、多个用户不断刷新,也会产生并发压力。
--query.timeout、--query.max-concurrency、--query.max-samples 等参数可以设置防线,但调小会让正常重查询失败,调大又可能放大内存风险。应先按实际版本 --help 确认,再用代表性查询做压测,不要复制一组号称“万能优化”的值。
6. 怎样做一次有意义的容量实验
在隔离环境保留原始基准:目标数、抓取间隔、响应大小、活跃序列、创建速率、查询延迟和资源峰值。一次只改变一个因素,例如目标数量翻倍,或者把抓取间隔从 15 秒调整为 30 秒。
预期采样速率会受间隔影响,但活跃标签集合不会因此自动减半。若换成归一化 route,活跃序列和 churn 才可能显著下降。保留查询正确性检查,防止通过删除关键指标“优化”出一张空图。
还要测重启后的 WAL 重放时间和压缩期间的磁盘峰值,不能只看稳态。容器内存限制应覆盖实际峰值;OOM 后不断重启可能让恢复阶段承受更大压力。
7. 典型案例:一次发布让内存增长,如何证明修复有效
假设服务发布后,抓取目标仍是一百个,内存却明显上涨。先确认增长来自 Prometheus 进程而不是节点其他程序,再比较发布前后的每目标样本数、活跃序列和新建速率。若 sample 数与 churn 同时上涨,应优先检查新版本暴露的指标和标签,而不是先缩短查询时间范围。
抽取一个目标的受控指标响应,和上一版本或设计清单比较。例如旧值是 route=/orders/{id},新值变成 route=/orders/12345。用几组不同订单请求验证,观察是否每个编号都创建新序列,便能把问题定位到具体的埋点规则。
修复应在源头恢复有限路由模板,并明确哪些路径合并。灰度实例上比较业务请求总量与错误总量,确认归一化没有漏计或把不同业务语义混为一类。历史高基数数据不会因源头修正立刻消失,但新建速度应先下降,随后活跃集合和长期块增长逐步趋稳。
若临时使用 metric relabel 降低影响,应在变更记录里写明丢弃了哪些指标、影响哪些图表和告警、计划何时撤销。保护阈值可以防止实例被击穿,却不能替代指标契约。修复结果至少包括相同流量下的资源对比和关键查询一致性,而不只是一张内存下降截图。
8. 验收不只看资源下降
治理后应同时确认:预期目标仍被抓取,关键 SLI 和告警没有丢失,查询数值与基准一致,内存与延迟改善可复现,采集保护没有持续触发。为重要 job 建立标签预算和变更评审,让高基数在上线前就能被发现,而不是等 TSDB 写满后再救火。
上一篇:TSDB 存储与容量:Head、WAL、保留策略和备份恢复 · 系列目录 · 下一篇:高可用架构:双 Prometheus 与 Alertmanager 集群