
本篇是《Prometheus 从入门到生产实践》第 23 / 24 篇。配置以文中版本与环境前提为准,实验和故障均为教学场景。完整程序、配置及校验范围见配套实验包。
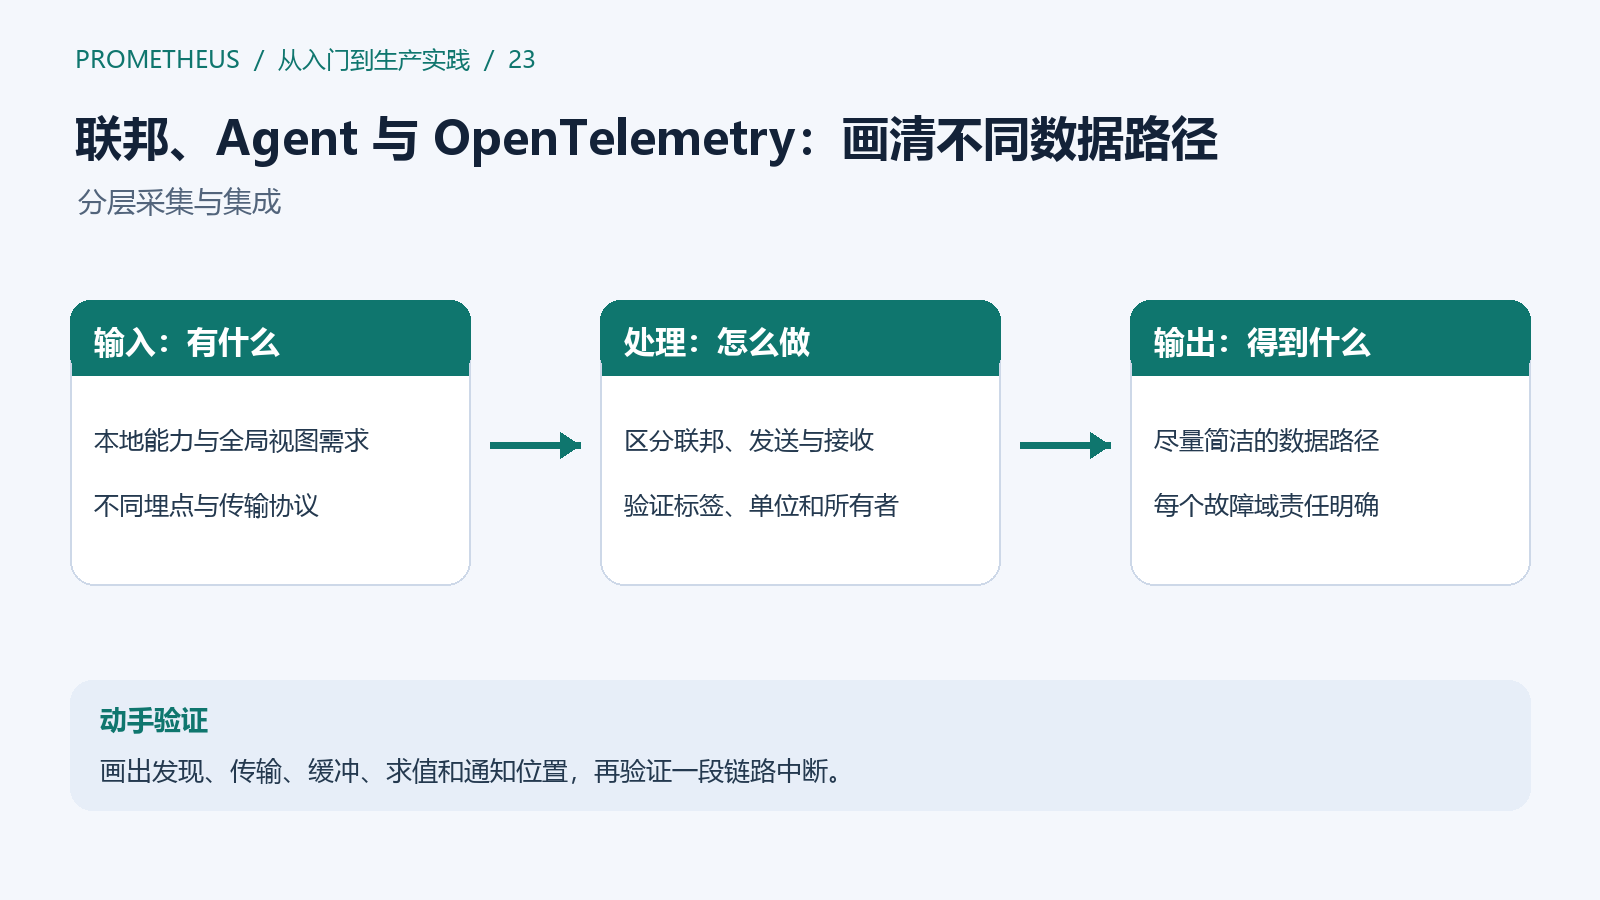
系统扩展以后,团队容易同时听到 federation、Remote Write、Agent、OpenTelemetry 等术语。它们有些解决采集位置,有些解决跨集群汇总,有些解决协议和业务埋点。把它们都当成“把数据推到另一台机器”会混淆能力与故障边界。
1. 先确定边缘需要保留哪些能力
如果网络中断后,机房仍要能够查询近期数据、执行告警规则,就需要在本地保留相应的 Server 能力。如果只要求在边缘抓取并向中心发送样本,可以评估 Agent。若只是中心查看各地区的汇总,联邦又是另一条路线。
选型前先写出“谁发现目标、谁发起抓取、谁保存历史、谁求值、谁通知、断网后谁还能工作”。这六个问题比先挑部署包名称更容易暴露需求缺口。
2. 联邦是向另一个 Prometheus 抓取选定序列
联邦使用源 Prometheus 的 /federate 端点,通过 match[] 选取当前可导出的序列,目标 Prometheus 再像抓取其他端点一样读取它。它不是复制源站完整 TSDB 历史,也不是把一段过去的时间窗口回填到中心。
下面是目的端的独立配置,源站仍是实验 Prometheus 19090;目的端应使用另一个监听端口和独立数据目录:
global:
  scrape_interval: 30s
scrape_configs:
  - job_name: federate-lab
    honor_labels: true
    metrics_path: /federate
    params:
      'match[]':
        - '{__name__="up",job="demo"}'
        - '{__name__="ops_demo_requests_total",job="demo"}'
    static_configs:
      - targets: ['127.0.0.1:19090']
honor_labels 保留源序列的 job、instance 等标签含义,避免被目的端本次 scrape 的同名标签替换。这样做依赖你信任并控制源站标签;同时需要地区或集群身份来区分不同源站的同名序列。配置机制见 Federation 官方说明。
实验中可以先直接观察响应:
curl --fail --max-time 5 --get \
  --data-urlencode 'match[]={__name__="up",job="demo"}' \
  http://127.0.0.1:19090/federate
预期能看到 demo 的 up 序列。再启动目的端,确认同一标签含义能被查询。原始 counter 联邦示例是为了观察链路;真正的跨区域层级汇总,通常更适合先在源站生成有明确语义的 recording rules,再把有限汇总传到上层。
3. 联邦会改变观测粒度
上层每 30 秒抓一次,不代表它拥有下层每 15 秒采样的全部细节。源站短暂出现的序列或高分辨率变化可能没有完整进入上层,远端也不能因此重建全部原始历史。
不要在每一层都对原本已经计算好的速率再做一次 rate。要区分“原始 counter”“区间速率 recording rule”和“跨实例聚合”各是什么量。分层聚合时还要保证单位、标签与统计窗口一致。
原生直方图经联邦传输,需要核对两端版本、启用配置和协商格式;只验证传统文本标量成功,不能据此宣称全部样本类型都已经兼容。
4. Agent 使用相同抓取机制,但不保留完整本地服务能力
Agent 是 Prometheus 二进制的一种运行模式,保留服务发现和抓取,围绕 Remote Write 优化;不提供 Server 模式那样的本地查询、recording rule 和告警求值。缓冲 WAL 用于发送,不等于本地可查询的长期历史。
独立配置示例如下,接收端仍为文档占位地址,实际使用前替换并配置授权:
global:
  scrape_interval: 15s
  external_labels:
    site: edge-lab
scrape_configs:
  - job_name: demo
    static_configs:
      - targets: ['127.0.0.1:19100']
remote_write:
  - name: central
    url: https://metrics.example.test/api/v1/write
prometheus --agent --config.file=c23-agent.yml \
  --storage.agent.path=./data/agent \
  --web.listen-address=127.0.0.1:39090
启动标志和缓冲保留选项应按具体版本 --help 核对。不要同时把 Server TSDB 的路径、规则和保留参数全部照搬给 Agent。能力边界见 Prometheus Agent Mode。
如果中心失联,Agent 可以在其缓冲预算内暂存待发送数据,但本地值班人员仍不能像访问完整 Prometheus 一样执行历史查询。若该能力是断网应急的硬需求,架构就不应只部署 Agent。
5. OpenTelemetry 不是 Prometheus 的别名
OpenTelemetry 提供指标、追踪、日志等信号的生成和传输生态,Collector 可以在不同 receiver、processor、exporter 之间组织数据流。Prometheus 主要处理指标,不会因为打开 OTLP 入口就自动变成追踪和日志后端。
常见路径包括:应用暴露 Prometheus 端点供抓取;OTel Collector 抓取后向指标后端 Remote Write;应用或 Collector 通过 OTLP/HTTP 发送指标到支持的 Prometheus 接收入口。选择哪条路线会影响队列、重试、属性转换和观测位置。
当前支持的 Prometheus 版本可通过 --web.enable-otlp-receiver 启用指标入口,HTTP 请求路径为 /api/v1/otlp/v1/metrics。入口默认关闭,并且需要配置访问边界和认证;按所用版本核对 OTel 集成指南。
6. 接入 OTel 时必须验收的映射
先区分 OTLP/HTTP 和 gRPC,不能把 HTTP 路径直接当成 gRPC 服务地址。还要区分 SDK 的通用 base endpoint 与 signal-specific endpoint:后者通常需要完整的 metrics 路径,语言实现支持也有差异。以 OTLP exporter 配置说明 和实际 SDK 请求日志核对,避免路径重复追加或遗漏。
接着检查 metric 名称、单位、resource attributes 到标签的提升、target_info、counter temporality、直方图表示、起始时间和乱序策略。不要把所有 resource attributes 都变成每条序列的标签:版本、实例和容器身份变化会带来 churn。
验收应使用一组已知请求:记录调用次数、错误次数、延迟分布与预期标签,在发送端和最终查询入口逐一对照。特别确认没有同时经“直接抓取”和“Collector 转发”把同一测量重复计数。
7. 练习:画出自己真正需要的数据流
选“跨区域汇总”“边缘只采集”“应用统一 OTel”中的一个场景,画出目标发现、传输协议、缓存位置、规则求值和故障域。人为中断一段测试链路,判断哪一端还能查询、告警或暂存,恢复后需要验证什么。
最终选型结果不必包含所有组件。每增加一个中间层,就增加一套资源、权限、版本和故障处理责任;让数据路径尽量简单,同时满足明确的本地能力和全局视图需求。
上一篇:Remote Write 与长期存储:队列、兼容与恢复预算 · 系列目录 · 下一篇:生产综合项目:灰度上线、故障演练与升级回滚