
本篇是《Prometheus 从入门到生产实践》第 24 / 24 篇。配置以文中版本与环境前提为准,实验和故障均为教学场景。完整程序、配置及校验范围见配套实验包。
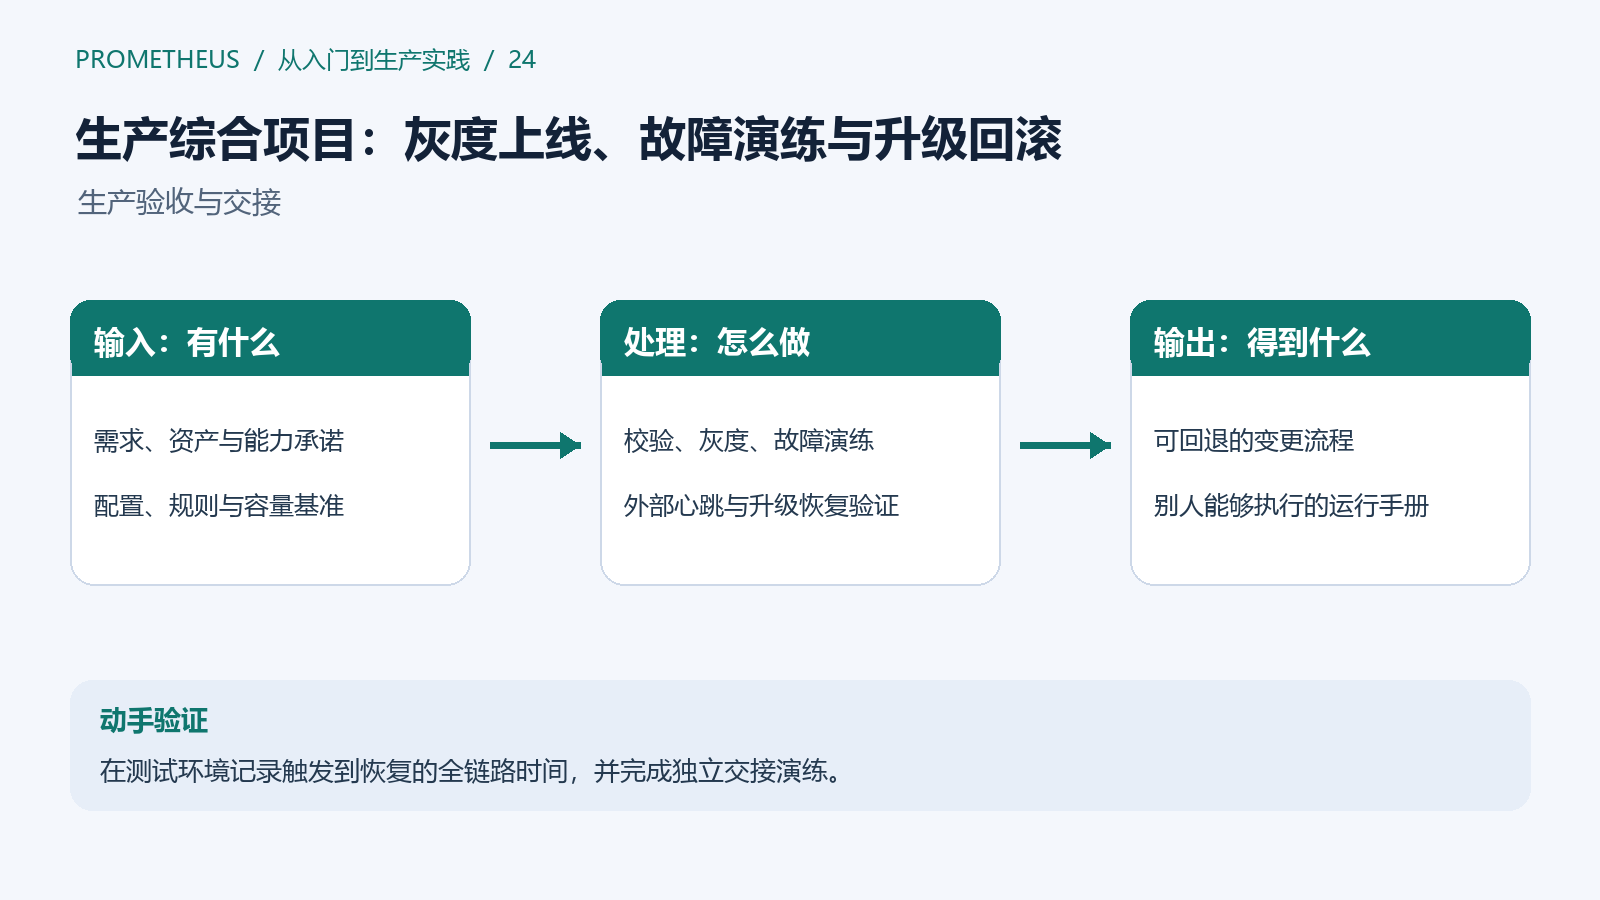
学会写配置和 PromQL 之后,最后需要交付的是一套别人能接手、故障时有证据、升级时可以控制风险的监控系统。本篇以教学业务服务为主线,把采集、查询、告警、安全、容量和恢复组织成一次分阶段项目。
1. 先给项目定义可验收的目标
假设需求是:监控 demo 的请求速率、错误比例和延迟;目标抓取失败与业务持续恶化能通知正确的人;监控自身失效能被外部发现;短期历史、本地恢复时间和长期保存范围都有明确承诺。
把期望写成具体问题:最长允许多久没发现?谁负责接收与处理?多少天原始数据留在本地?某节点失效后保留什么能力?恢复要多久?哪些查询必须在多长时间内完成?
不要先承诺一个“99.99% 高可用”,再拼组件。监控链路与被监控业务分别有自己的服务目标,发送成功也不等同于值班人员已经响应。
2. 第一阶段:固定基准,再验证最短链路
在隔离环境启动教学 exporter 19100、Prometheus 19090、Alertmanager 19093,使用独立目录与回环监听。记录实际二进制版本、配置哈希和所有启动参数。
持续产生可控的成功和失败请求,先检查 /metrics 的计数与直方图,再确认 Targets 正常,最后用固定窗口查询 rate、错误比例及延迟。至少等待窗口内有足够样本;启动后的空结果不能直接当成零错误。
为后续步骤保存一份基准:目标标签、预期序列、请求总量、错误量、图表单位、告警状态及响应截图或导出的查询结果。数值在变化时,要记录查询时刻和范围,而不是只保存一张没有时间的图。
3. 第二阶段:把配置变更变成可复现流程
把 scrape、file_sd、recording rules、alerting rules 和通知路由放进版本管理,配置中只引用凭据位置,不提交真实令牌。记录服务发现与 Operator 资源的实际拥有者,避免手工修改由控制器生成的文件。
每次变更先在对应版本运行校验:
promtool check config prometheus.yml
promtool check rules rules/*.yml
amtool check-config alertmanager.yml
这些路径是项目目录约定,需替换为实际文件。规则单元测试补充 counter reset、低流量、缺失、匹配唯一性和告警持续时间。文件检查通过后,在测试实例加载,并查看运行时配置和规则健康状态;校验工具不会证明网络、认证或接收器正确。
变更记录至少包括原因、影响 job、预期序列增量、回退文件和验收查询。这样发现资源增长时,可以追到是哪次指标或发现规则变更。
4. 第三阶段:灰度一个 job,观察容量与正确性
先接入一小组有代表性的目标,不要第一天直接全量发现所有 namespace。比较接入前后的目标数、每次样本数、活跃序列、churn、内存、CPU、磁盘和查询延迟。
验证关键 SLI 没有被 relabel 丢掉,经典直方图的 le 保留,聚合维度与看板一致。为采集限制留余量,并配置限制触发时的诊断入口。确认估算不只是“当前磁盘还能放下”,还覆盖 WAL、压缩、备份和发布增长。
达成预算后按批次扩展,保留每批数据和观察时长。若需要缩回范围,回退具体发现选择器或指标来源,而不是用随机删目录来降低磁盘占用。
5. 第四阶段:让每种故障都有预期证据
| 专用测试故障 | 需要验证的结果 |
|---|---|
| 停止 demo exporter | up 失败、Targets 原因、告警持续时间和恢复 |
| 保持 exporter 正常但提高错误比例 | up 仍为 1,业务 SLI 告警能独立出现 |
| 规则引用错误或语义不符 | 文件/规则检查和运行时错误能被发现 |
| 测试接收端不可用 | 告警仍存在,通知失败与重试可观察 |
| 单 Prometheus/AM 实例停止 | 符合已设计 HA 能力,不把重复通知算成未知事件 |
| 远端存储暂不可达 | 积压与预算明确,恢复后追平并核对缺口 |
演练只能影响专用目标和授权接收端。每项记开始、首次被观察到、firing、首次收到、恢复和恢复通知时间,并解释中间各段延迟。把实际耗时与承诺比较,而不是只写“演练通过”。
6. 第五阶段:监控系统也需要被监控
本地 Prometheus 挂了以后,它自己无法及时求值“我已经挂了”的告警。因此需要独立位置的探测、另一套监控,或外部接收心跳的 dead-man's-switch。
配套的自监控规则示例如下,只有加载并送到正确接收链路才生效:
groups:
  - name: monitoring-self
    interval: 30s
    rules:
      - alert: MonitoringWatchdog
        expr: vector(1)
        labels:
          severity: none
          environment: lab
        annotations:
          summary: '监控通知链路心跳:持续存在是预期行为'
      - alert: MonitoringRuleEvaluationFailed
        expr: increase(prometheus_rule_evaluation_failures_total[10m]) > 0
        labels:
          severity: warning
        annotations:
          summary: '规则求值失败,请查看 Prometheus 规则状态和日志'
MonitoringWatchdog 持续存在是预期;真正要发现的是外部接收端一段时间未收到它。不能把它当成普通故障告警让值班手机不停响。规则求值失败的指标也应先确认版本实际暴露,并抓取 Prometheus 自身。
还需要观测配置重载失败、TSDB 写入与压缩问题、查询压力、远端发送、Alertmanager 通知错误及磁盘余量。告警设计可参照 Alerting practices,重点是能引导行动和定位原因。
7. 升级要按数据兼容性设计回滚
先阅读当前到目标版本之间的迁移说明和发布记录,核对 PromQL 行为、配置字段、抓取协议、原生直方图、Remote Write/OTLP 与后端兼容。用目标版本的 promtool 检查配置,但也保留实际运行版本的校验结果。
在克隆或测试数据上启动新版本,测量 WAL 重放、历史查询和规则行为。对于双副本,先升级一份,观察足够长的代表性窗口,确认另一份仍提供原来的保障后再继续。
不要假设回滚就是把二进制换回去。新版本可能写入旧版本不能读取的数据或状态,回滚要按已验证的兼容路径,必要时使用升级前备份或另一份尚未升级副本。不得让不同版本进程同时写同一个 TSDB。
Prometheus 3 的重大变化应阅读 Migration guide,具体版本再核对对应 release notes。保留安装包、校验摘要、配置、规则、启动参数与恢复记录,才能让回退步骤真正可执行。
8. 交接时交付一份能被接手的运行手册
运行手册应包含组件与数据流、负责人、资产范围、标签约定、规则与看板、容量预算、权限和凭据更新路径、备份恢复记录、常见故障入口及变更回退流程。
再让另一个人在没有口头补充的情况下,用手册完成一次查询、一次规则检查和一次测试故障定位。凡是必须靠“你记得某台机器在哪里”才能继续的步骤,都需要补到文档。
至此,教程的终点不是部署了最多组件,而是能够解释数据怎样进入、查询为何正确、告警怎样到人、故障损失多大,以及变更后如何证明系统仍符合承诺。
上一篇:联邦、Agent 与 OpenTelemetry:画清不同数据路径 · 系列目录 · 本篇为系列收尾